İş Zekası Bellek Duvarına Çarptığında: Kıt RAM Çağında Performansı Yeniden Düşünmek
RAM artık ucuz ve sınırsız değilse, Qlik Sense’in tamamen bellek içi modeline ne olur? Qlik’in kendi dokümantasyonunu ve akıllı önbellekleme üzerine sahip olduğumuz patenti kullanarak, TURBOARD’un hibrit mimarisiyle karşılaştırıyoruz.
Son on yılın büyük bölümünde iş zekası platformları rahat bir varsayım üzerine inşa edildi: bellek hep daha ucuz, daha yoğun ve sorunlara çözüm olarak rahatça eklenebilir hâle gelecekti. Bu varsayım sessizce kırılıyor. Yapay zeka altyapısının yaygınlaşması, küresel DRAM ve HBM arzının benzeri görülmemiş bir bölümünü tüketiyor; başlıca bellek üreticileri, kısıtlamaların 2026 boyunca derinleşmesinin muhtemel olduğu konusunda uyarıda bulundu. Kurumsal iş zekası ekipleri için pratik etkisi açık: analitik platformunuzun bağımlı olduğu RAM artık daha pahalı, daha rekabetçi ve talep üzerine ölçeklendirilmesi daha zor bir kaynağa dönüşüyor.
Bu, sorulması gereken soruyu değiştiriyor.
Geleneksel iş zekası performans sorusu şöyleydi: veri seti belleğe sığdığında görselleştirme ne kadar hızlı? Üreticilerin sevdiği bir sorudur, çünkü cevap neredeyse her zaman “çok hızlı” olur. Ancak bu artık bir platformun gerçek üretim ortamında ayakta kalıp kalmayacağına karar veren soru değil. Asıl önemli soru şu: veri hacimleri büyürken, eşzamanlı kullanıcı sayısı katlanırken ve bellek artık istediğinizde satın alabileceğiniz bir kaynak değilken platform nasıl davranıyor?
Bu sorunun bugünün pazarında çok farklı iki yanıtı var. Qlik Sense, olgun bellek içi okulu temsil ediyor — tüm veriyi RAM’e yükle, orada tut ve ilişkisel bir motorun yakınlık üzerinden hız sağlamasına izin ver. TURBOARD ise hibrit bir okul temsil ediyor — belleği yalnızca en çok fayda sağlayan iş yükleri için bir hızlandırma katmanı olarak kullan ve geri kalan her şeyi sütun odaklı depolamaya veya iş için tasarlanmış canlı kaynaklara yönlendir.
Her iki yaklaşım da çalışır. İlginç soru, koşullar değiştikçe hangisinin zamana karşı daha iyi dayandığıdır. Bu yazı, veri büyüdükçe, kullanıcı sayısı arttıkça ve RAM daraldıkça her mimarinin gerçekte ne yaptığını adım adım inceliyor — kanıt olarak Qlik’in kendi dokümantasyonunu ve TURBOARD’un yayımlanmış mimarisini kullanıyor.
Kısaca iki mimari
Qlik Sense, QIX ilişkisel motoru üzerine kuruludur. Bir uygulama yüklendiğinde, toplanmamış (unaggregated) veri seti, her bir değeri diğerine bağlayan ilişkisel yapılarla birlikte tamamen RAM’de tutulur. Kullanıcı seçimleri bu bellek içi yapılar dolaşılarak yanıtlanır ve hesaplama sonuçları RAM’de önbelleğe alınır, böylece sonraki aynı istekler anında geri döner.
Qlik’in kendi QVD biçimi yükleme katmanını dramatik şekilde hızlandırır — Qlik dokümantasyonu, QVD okumalarının diğer kaynaklara göre on ila yüz kat daha hızlı olduğunu belirtir — ancak çalışma anındaki model hâlâ aktif veri setinin fiziksel bellekte yer almasını gerektirir.
TURBOARD farklı bir yol izler. Veriye, yerel veritabanı sürücüleri kullanılarak optimize edilmiş canlı bağlantılar üzerinden erişilebilir veya MariaDB ColumnStore, ClickHouse ya da Vertica gibi yüksek performanslı bir sütun odaklı (columnar) depoya aktarılabilir. Sık kullanılan sorgu sonuçları, bellek içi veri yapısı deposu olan Redis’te önbelleğe alınır.
Bir önbellek tetikleyici (cache trigger) mekanizması, önbelleklenmiş sonuçların hâlâ geçerli olup olmadığına ve kaynağın yeniden sorgulanması gerekip gerekmediğine karar verir. Bellek, tüm analitik verinin varsayılan deposu olarak değil; en çok hızlandırma sağlayan iş yükleri için bilinçli olarak kullanılır.
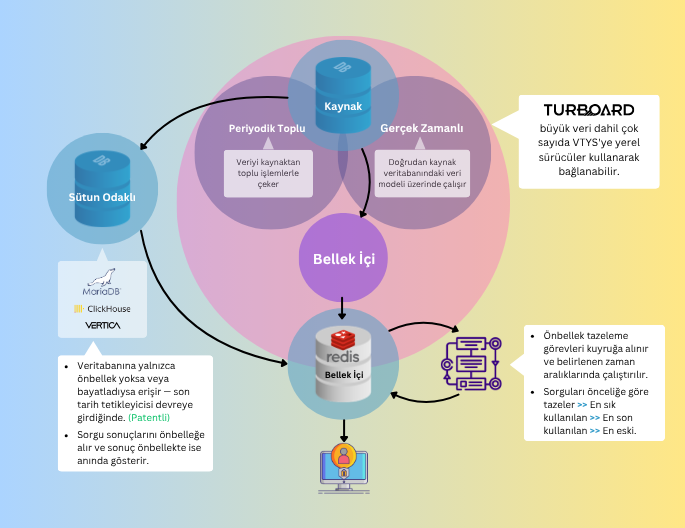
Yukarıdaki diyagram, TURBOARD’un katmanlarının nasıl bir araya geldiğini gösteriyor. Yazının geri kalanı, koşullar zorlaştıkça her bir mimarinin nasıl davrandığını inceliyor.
Adil senaryo: bellek içi yaklaşımın kazandığı durum
Açık konuşmak gerekir: veri seti RAM’e rahatça sığdığında, eşzamanlı kullanım ölçülü olduğunda ve ortam uygulamaya göre boyutlandırıldığında Qlik Sense gerçekten hızlıdır. İlişkisel motor olgun bir mühendislik ürünüdür ve filtreler arasında tıklayıp toplulaştırmaların milisaniyeler içinde yeniden hesaplanmasını izlemek, iyi bir günde mükemmel bir kullanıcı deneyimidir. Departman düzeyindeki dağıtımlar, odaklanmış analitik uygulamalar ve veri modelinin sabit ve iyi anlaşıldığı iş yükleri için bellek içi yaklaşım gerçek bir güçtür.
Ürün demolarının çoğu bu senaryo etrafında kurulur. Aynı zamanda bu, bir platformun bir yıllık üretim hayatından sonra — veri büyüdüğünde, kullanıcı tabanı genişlediğinde ve aynı sunucuya üç uygulama daha yerleştirildiğinde — nasıl davranacağı hakkında size en az şeyi söyleyen senaryodur.
Ölçeklenme senaryosu: mimarilerin ayrıştığı nokta
Qlik’in kendi destek dokümantasyonu bellek modelini ayrıntılı olarak tanımlar. Motor, sırasıyla fiziksel RAM’in %70 ve %90’ı varsayılan değerlerine sahip olan ve Working Set Low ile Working Set High olarak bilinen iki yapılandırılabilir eşik karşısında çalışır. Düşük eşiğin altında motor, kullanılmayan belleğin boşa harcanan bellek olduğu prensibiyle, önbelleklenmiş hesaplama sonuçlarını ısrarla saklar. Düşük eşik aşıldığında motor, yeni sonuçlara yer açmak için önbelleklenmiş sonuçları silmeye başlar; silmeyi yaşa, boyuta ve ilk hesaplama süresine göre önceliklendirir. Yüksek eşik aşıldığında, önbellekleme fiilen durur ve motoru ayakta tutmak için işletim sisteminin sayfa dosyası (pagefile) devreye girebilir. Qlik’in dokümantasyonu, sayfa dosyası kullanımının performansı ciddi biçimde düşürebileceğini belirtir.
Bu eşikler arasında olup biten mekanik, eşiklerin kendisinden daha önemlidir. Silinen her önbellek sonucu, bir sonraki kullanıcı isteğinde sıfırdan yeniden hesaplanması gereken bir işlemdir. Silme hızlandıkça, hesaplama yükü bellekten CPU’ya kayar. Yüksek eşzamanlı bir ortamda — birçok kullanıcının aynı anda artık önbelleklenmiş yanıtı olmayan hesaplamaları tetiklediği bir ortamda — CPU yeni darboğaza dönüşür. Ve bellek baskısının aksine, CPU baskısı doğrudan kullanıcıların gördüğü gecikmeye yansır: takılan görselleştirmeler, uygulanması saniyeler süren filtreler, zaman aşımına uğrayan oturumlar.
TURBOARD’un hibrit yaklaşımı yükü farklı dağıtır. Toplanmamış veri setinin RAM’i işgal etmesine gerek yoktur, çünkü sütun odaklı (columnar) depo, analitik sorgulara doğrudan diskten verimli yanıt vermek üzere tasarlanmıştır — yalnızca sorgunun dokunduğu sütunları okur, yoğun sıkıştırmadan yararlanır ve on yıl önce ancak bellek içi işlem ile mümkün olan hızlarda toplulaştırma sunar. Artımlı yükleme (incremental load), sütun odaklı depoyu sürekli tam yeniden yüklemeye zorlamadan güncel tutar; böylece kullanıcılar, tüm veri setini RAM’de tutmanın bellek maliyetini ödemeden neredeyse canlı bir veri deneyimi yaşar. Redis önbelleği ise hızlandırmadan en çok fayda sağlayan sorguları hızlandırır — bu da gerçek bir kurumsal dağıtımda toplam sorgu hacminin küçük bir alt kümesidir. Bir sonraki bölüm bunun nedenini açıklıyor.
Canlı veri: Direct Discovery sorunu
Qlik’in mevcut belleği aşan iş yüklerine yanıtı Direct Discovery’dir. Bu modda, boyut (dimension) alanları belleğe yüklenirken, ölçü (measure) alanları kaynak veritabanında kalır ve talep üzerine sorgulanır. Tasarım amacı makul; ancak belgelenmiş kısıtlamalar ciddidir.
Direct Discovery’nin belgelenmiş kısıtlamaları (Qlik’in kendi yardım belgelerine göre):
- Bir uygulamayı kullanan tüm kullanıcılar için tek paylaşımlı veritabanı bağlantısı — yüksek eşzamanlılıkta kaynak veritabanını sorguya boğabilir.
- Üretilen SQL optimize edilmez; bellek içi tablolar ile Direct Discovery tabloları arasındaki birleştirmeler (join), veritabanı sorgu tamponlarını zorlayabilen çok büyük IN ifadeleri üretebilir.
- Birçok temel analitik yetenek desteklenmez, bunlar arasında Set Analysis, Insight Advisor ve Dynamic Views yer alır.
- Bu kısıtlamaları aşmak için yeni geliştirme planlanmamaktadır, Qlik’in kendi açıklamasına göre.
TURBOARD için canlı bağlantı, bellek baskısını aşmak için bir geçici çözüm değildir. Mimarinin birinci sınıf bir parçasıdır. Genel ODBC bağlantıları yerine kullanılan yerel veritabanı sürücüleri, Apache Kudu gibi büyük veri platformları dahil kaynak sistemlere doğrudan ve yüksek performanslı erişim sağlar. Önbellek tetikleyici mekanizması, kaynak veritabanının her kullanıcı tıklamasında sorgulanmasını engeller: TURBOARD belirlenmiş bir tetikleyici alanı (örneğin son güncelleme zaman damgası) izler ve altta yatan veri değişmediğinde sonuçları doğrudan Redis önbelleğinden sunar; yalnızca tetikleyici taze veri olduğunu gösterdiğinde kaynağa sorgu atar. Bir görsel ister önbellekten, ister sütun odaklı depodan, isterse canlı kaynaktan beslensin, gelişmiş analitik özellikler tam olarak çalışmaya devam eder. Tek bir görselleştirme, üçünü de hiçbir taviz vermeden bir araya getirebilir.
Pareto içgörüsü ve onu koruyan patent
Her kurumsal iş zekası dağıtımında kullanıcı davranışı öngörülebilir bir kalıp izler. Kullanıcıların yaklaşık %80’i sürekli olarak aynı temel görselleştirmelere döner — yönetici özetleri, aylık performans raporları, bölgesel toplulaştırmalar. Geri kalan %20 ise aynı biçimde bir daha asla çalıştırılmayabilecek anlık (ad-hoc) sorgular yürüten ileri düzey kullanıcılardır. Bellek yönetimi açısından sonuç doğrudandır: önbelleklenmiş tüm sonuçlar eşit değerde değildir ve hepsine eşit muamele eden bir sistem en pahalı kaynağını boşa harcar.
Qlik’in silme modeli kullanıcı davranışına karşı kördür. Önbelleklenmiş sonuçlar yaşa, boyuta ve ilk hesaplama süresine göre kaldırılır — gerçek kullanıcıların aslında ne sıklıkla istediğine bakılmaz. Bellek dolduğunda motor, yönetim ekibinin her sabah baktığı görselleştirmeyi, son zamanlarda tesadüfen önbelleğe alınmış tek seferlik bir sorgudan ayırt edemez.
TURBOARD ise tam tersi yaklaşımı benimser. Bir rapor her görüntülendiğinde, popülerlik puanı tam olarak bu tür sıralı erişim örüntüleri için tasarlanmış bir veri yapısı olan Redis Sorted Set içinde artırılır. Sistem, hangi raporların gerçekten kullanıldığına dair sürekli güncellenen bir liderlik tablosu tutar ve bellek kıt olduğunda önbellekte neyin kalacağına bu tabloya göre karar verir. En çok talep edilen raporlar Redis’te koruma altına alınır; onlara bağımlı kullanıcıların büyük çoğunluğuna sıfır gecikmeyle yanıt döner. Önbelleği ıskalayan ileri düzey kullanıcı sorguları ise, bu tür sorgulara yüksek değerli önbellek içeriğini taşırmadan hızlıca yanıt verecek şekilde tasarlanmış sütun odaklı depoya veya canlı kaynağa yönlendirilir.
Kullanıcı Alışkanlıklarına Uyum Sağlayan Yapay Zeka Destekli Hızlı Arama Sonucu Gösterim Sistemi
Bu mekanizma, tescilli bir patentin konusudur. Sistem, E-Kalite (TURBOARD’un üreticisi) tarafından 2022’de başvurusu yapılmış ve 2025’te tescil edilmiştir. Patent; kullanıcı arayüzünde veri gösterimini hızlandırma, giriş/çıkış yükleme sürelerini kısaltma ve veriyi saklayan ve/veya ileten donanımların kullanım sıklığını azaltma yöntemini kapsar — bir başka deyişle, TURBOARD’un yalnızca bellek içi mimarileri sayfa dosyası bölgesine itecek bellek bütçeleriyle kurumsal iş yüklerini sürdürmesini sağlayan kullanım skoruna dayalı puanlama, akıllı önbellek tazeleme ve tetikleyici tabanlı eskime tespitinin birleşimidir.
Stratejik nokta açıktır: bellek bolken kullanıcı davranışından habersiz önbellekleme size verimlilik kaybettirir. Bellek kıt olduğunda ise performans kaybettirir.
Yan yana karşılaştırma
| Soru | Qlik Sense Yaklaşımı | TURBOARD Yaklaşımı |
|---|---|---|
| Veri çalışma anında nerede yaşar? | Tamamı RAM’de | Sütun odaklı depoda veya canlı kaynakta; sonuçlar Redis’te seçici şekilde önbelleğe alınır |
| Bellek dolduğunda ne olur? | Yaşa/boyuta göre önbellek silme, ardından sayfa dosyası | Davranış puanına göre koruma; taşan istekler sütun odaklı depodan veya canlı kaynaktan sunulur |
| Tekrar eden kullanım nasıl yönetilir? | Bellek içi sonuç önbelleği, kör şekilde silinir | Redis önbelleği, kullanım skoruna göre korunur (patentli) |
| Veri tazeliği nasıl korunur? | Tam veya QVD-artımlı yüklemelerle RAM’e | Sütun odaklı depoya artımlı yükleme + önbellek tetikleyicileri |
| Canlı sorgular nasıl yönetilir? | Direct Discovery, belgelenmiş kısıtlamalarla | Yerel sürücüler, tüm analitik özellikler korunur |
| Ölçeklenme felsefesi | Daha fazla bellek temin et | Belleği seçici kullan, gerisini yönlendir |
Sonuç
Qlik Sense, yetkin bir bellek içi analitik platform olmaya devam ediyor; tasarlandığı koşullarda — sınırlı veri setleri, öngörülebilir eşzamanlılık, cömert bellek tahsisi — iyi bir performans sergiliyor. Bu yazının yanıtlamaya çalıştığı soru, bu koşulların karşılanmasının zorlaştığı bir dönemde ne olacağıdır. Veri hacimleri küçülmüyor. Eşzamanlılık beklentileri gevşemiyor. Ve uzun zamandır ilk kez, bellek maliyeti ve bulunabilirliği yanlış yönde hareket ediyor.
TURBOARD’un mimarisi, iş zekasında performansın önümüzdeki on yılda belleği bolca değil akıllıca kullanan platformlar tarafından kazanılacağına dair bir bahistir. Hibrit veri erişimi, sütun odaklı depolama, yerel canlı bağlantı ve patentli kullanım puanına dayalı önbellek; TURBOARD’un yalnızca bellek içi mimarilerin zorlandığı bellek bütçeleriyle kurumsal ölçekli performans sunmasına olanak tanır.
Büyüyen veri, artan eşzamanlılık ve sıkışan donanım ekonomisinin çarpıştığı bir noktada duran kuruluşlar için bu yaklaşım farkı artık akademik değil. İşle birlikte ölçeklenen bir platform ile satınalma bütçesiyle birlikte ölçeklenen bir platform arasındaki farktır.
Farkı Yerinde Görmeye Hazır mısınız?
Qlik Sense’i değerlendiriyorsanız — ya da hâlihazırda kullanıyor ve bu yazıda anlatılan bellek baskısını hissetmeye başladıysanız — TURBOARD’un hibrit mimarisinin aynı iş yüklerini nasıl yönettiğini size göstermekten memnuniyet duyarız.
Ekibimizle bir tanışma görüşmesi planlayın ve platformu kendi verilerinizle iş başında görün. Hiçbir baskı yok — ihtiyaçlarınıza en uygun çözümü bulmanızı tercih ederiz.
Daha fazla kurumsal senaryoda nasıl konumlandığımızı görmek için Tam İş Zekası Karşılaştırma sayfamızı da inceleyebilirsiniz.
Son Blog Yazıları




Görselleştirme oluşturmayı bırakın, cevap almaya başlayın. Lider Üretken Yapay Zeka özelliklerimizle İş Zekası'nın yeni çağını ücretsiz deneyimleyin.