Quand la BI se heurte au mur de la mémoire : repenser les performances à l’ère d’une RAM limitée
Qu’arrive-t-il au modèle en mémoire de Qlik Sense lorsque la RAM n’est plus bon marché ou disponible à l’infini ? Nous le comparons à l’architecture hybride de TURBOARD en utilisant la propre documentation de Qlik et notre brevet accordé sur la mise en cache intelligente.
Pendant la majeure partie de la dernière décennie, les plateformes de Business Intelligence ont été construites sur une hypothèse confortable: la mémoire continuerait à devenir moins chère, plus dense et plus facile à ajouter pour résoudre les problèmes. Cette hypothèse est tranquillement rompue. Les constructions d'infrastructures d'IA absorbent une part sans précédent de l'offre mondiale de DRAM et de HBM, et les principaux fabricants de mémoire ont averti que les contraintes devraient s'aggraver jusqu'en 2026. Pour les équipes de BI d’entreprise, l’effet pratique est simple – la RAM dont dépend votre plate-forme d’analyse devient plus chère, plus contestée et plus difficile à mettre à l’échelle à la demande.
Cela change la question qui compte.
La question traditionnelle de la performance de BI était: à quelle vitesse le tableau de bord est-il lorsque le jeu de données s'adapte en mémoire? C’est la question que les vendeurs aiment, car la réponse est presque toujours «très rapide». Mais ce n’est plus la question qui décide si une plateforme va tenir dans la production. La vraie question maintenant est: comment la plateforme se comporte-t-elle lorsque les volumes de données augmentent, que les utilisateurs simultanés se multiplient et que la mémoire est la ressource dont vous ne pouvez pas simplement acheter plus?
Cette question a deux réponses très différentes sur le marché aujourd'hui. Qlik Sense représente l’école mature dans la mémoire – chargez tout dans la RAM, gardez-le là et laissez un moteur associatif fournir une vitesse par la proximité. TURBOARD représente une école hybride – traiter la mémoire comme une couche d’accélération pour les charges de travail qui en bénéficient le plus, et acheminer tout le reste vers le stockage colonnaire ou les sources en direct conçues pour le travail.
Les deux philosophies fonctionnent. La question intéressante est de savoir lequel vieillit mieux à mesure que les conditions qui l’entourent changent. Cet article explore ce qui arrive réellement à chaque architecture à mesure que les données augmentent, les utilisateurs augmentent et la RAM se raréfie – en utilisant la propre documentation de Qlik et l’architecture publiée de TURBOARD comme preuve.
Deux architectures, brièvement
Qlik Sense est construit autour du moteur associatif QIX. Lorsqu'une application se charge, l'ensemble de données non agrégé est conservé dans la mémoire vive, ainsi que les structures associatives qui relient chaque valeur à toutes les autres valeurs. Les sélections des utilisateurs sont traitées en parcourant ces structures en mémoire, et les résultats de calcul sont mis en cache dans la mémoire vive, de sorte que les requêtes identiques ultérieures reviennent instantanément.
Le propre format QVD de Qlik accélère considérablement la couche de chargement – la documentation de Qlik indique que les lectures QVD sont dix à cent fois plus rapides que celles d’autres sources – mais le modèle d’exécution nécessite toujours que l’ensemble de données de travail vive dans la mémoire physique.
Le TURBOARD prend un chemin différent. Les données peuvent être accessibles via des connexions en direct optimisées à l'aide de pilotes de base de données natifs, ou importées dans un stockage colonnaire haute performance tel que MariaDB ColumnStore, ClickHouse ou Vertica. Les résultats de requête fréquemment utilisés sont mis en cache dans Redis, le magasin de la structure de données en mémoire.
Un mécanisme de déclenchement de cache décide quand les résultats mis en cache sont toujours valides et quand la source doit être interrogée à nouveau. La mémoire est utilisée délibérément, pour les charges de travail où elle produit le plus d’accélération – pas comme la maison par défaut pour toutes les données analytiques.
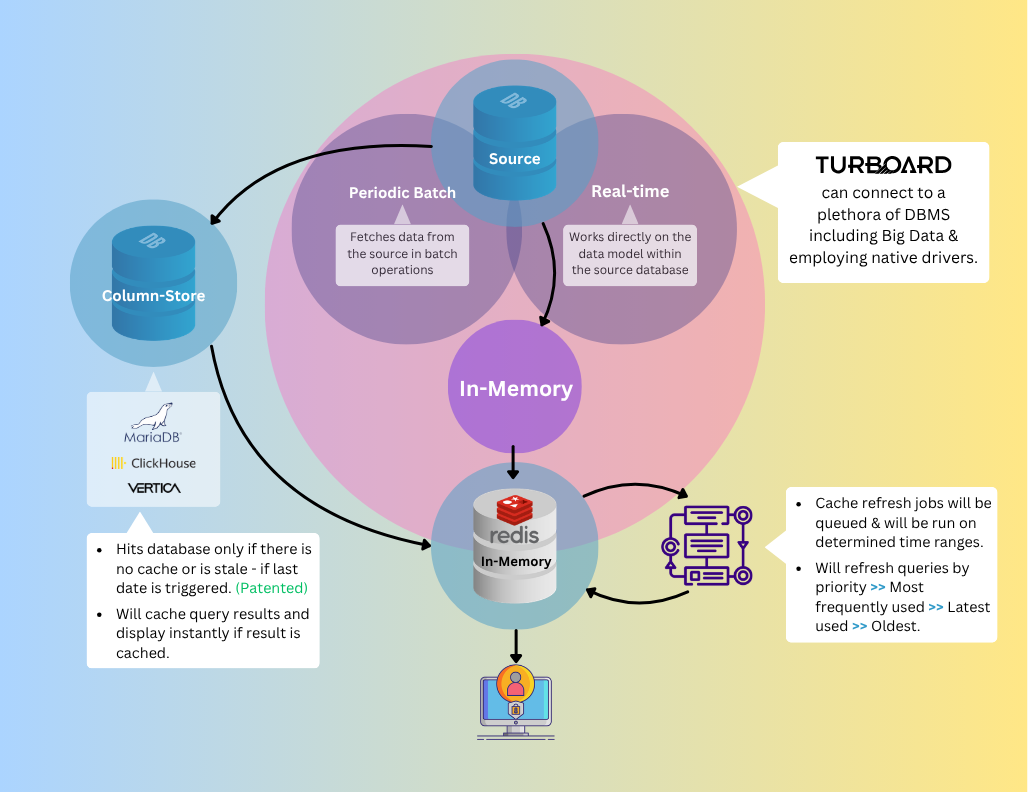
Le diagramme ci-dessus montre comment les couches de TURBOARD s’emboîtent. Le reste de l'article examine ce que chaque architecture fait à mesure que les conditions qui l'entourent deviennent plus difficiles.
Le scénario favorable : quand le traitement en mémoire l’emporte
Il vaut la peine de dire clairement: lorsque l'ensemble de données s'adapte confortablement à la mémoire vive, lorsque la concurrence est modeste et lorsque l'environnement est dimensionné pour l'application, Qlik Sense est vraiment rapide. Le moteur associatif est une pièce d'ingénierie mature, et l'expérience de l'utilisateur de cliquer à travers des filtres et de regarder les agrégations recalculer en millisecondes est, dans les bonnes conditions, excellente. Pour les déploiements à l’échelle d’un service, les applications analytiques ciblées et les charges de travail où le modèle de données est stable et bien compris, l'approche en mémoire est une véritable force.
C’est le scénario dans lequel la plupart des démonstrations de produits sont construites. C’est également le scénario qui vous indique le moins comment une plate-forme se comportera après un an en production, après la croissance des données, la base d’utilisateurs s’est étendue et trois autres applications ont été déployées sur le même serveur.
Le scénario de mise à l'échelle: où les architectures divergent
La propre documentation de support de Qlik décrit le modèle de mémoire en détail. Le moteur fonctionne contre deux seuils configurables dits Jeu de travail bas et ensemble de travail élevé, avec des valeurs par défaut de 70% et 90% de RAM physique respectivement. En dessous du seuil bas, le moteur conserve les résultats de calcul mis en cache de manière agressive, sur le principe que la mémoire inutilisée est de la mémoire gaspillée. Une fois le seuil bas franchi, le moteur commence à expulser les résultats mis en cache pour faire de la place pour de nouveaux, en donnant la priorité à l'expulsion par âge, taille et temps de calcul d'origine. Une fois le seuil élevé franchi, la mise en cache s’arrête pratiquement et le fichier d’échange du système d’exploitation peut être engagé pour maintenir le moteur en vie. La documentation de Qlik note que l'utilisation du fichier d’échange peut dégrader les performances de manière significative.
La mécanique de ce qui se passe entre ces seuils importe plus que les seuils eux-mêmes. Chaque résultat mis en cache qui est expulsé est un calcul qui devra être calculé à nouveau la prochaine fois qu'un utilisateur le demande. Au fur et à mesure que l'expulsion s'accélère, la charge de calcul passe de la mémoire au CPU. Dans un environnement à haute concurrence, où de nombreux utilisateurs déclenchent simultanément des calculs qui n’ont plus de réponses mises en cache, le CPU devient le nouveau goulot d’étranglement – et contrairement à la pression de la mémoire, la pression du processeur se manifeste directement sous forme de latence utilisateur-visible: tableaux de bord qui se bloquent, filtres qui prennent des secondes à appliquer, sessions qui expirent.
L’approche hybride de TURBOARD répartit la charge différemment. L'ensemble de données non agrégé n'a pas besoin d'occuper la RAM, car le stockage colonnaire est conçu pour répondre efficacement aux requêtes analytiques à partir du disque — ne lisant que les colonnes qu'une requête touche, en exploitant la compression lourde et en servant des agrégations à des vitesses qui auraient nécessité un traitement en mémoire il y a une dizaine d'années. Le chargement progressif maintient le stockage colonnaire frais sans forcer les recharges complètes répétées, ce qui signifie que les utilisateurs font l'expérience de données en quasi-temps réel sans le coût de la mémoire de la détention de l'ensemble complet de données dans la mémoire vive. Le cache Redis accélère alors les requêtes qui bénéficient le plus de l'accélération - qui, dans tout déploiement réel de l'entreprise, est un petit sous-ensemble du volume total de requêtes. La section suivante explique pourquoi.
Données en direct: le problème de la découverte directe
La réponse de Qlik aux charges de travail qui dépassent la mémoire disponible est Direct Discovery, un mode dans lequel les champs de dimension sont chargés en mémoire tandis que les champs de mesure restent dans la base de données source et sont interrogés sur demande. L'intention de conception est raisonnable; les limites documentées sont importantes.
Limites documentées de Direct Discovery (par le matériel d’aide de Qlik):
- Connexion de base de données partagée unique pour tous les utilisateurs d'une application - peut inonder la base de données source sous concurrence élevée.
- Le SQL généré n’est pas optimisé; Les jointures entre les tables en mémoire et les tables Direct Discovery peuvent produire de très grandes clauses IN qui sollicitent fortement les tampons de requêtes de la base de données.
- Plusieurs capacités analytiques de base ne sont pas supportées, y compris l'analyse des ensembles, Insight Advisor et Dynamic Views.
- Aucun développement supplémentaire n'est prévu pour remédier à ces limitations, selon la déclaration de Qlik.
Pour TURBOARD, la connectivité en direct n’est pas une solution de contournement pour la pression de la mémoire. C’est une partie de première classe de l’architecture. Les pilotes de base de données natifs – plutôt que les connexions ODBC génériques – fournissent un accès direct et haute performance aux systèmes sources, y compris les plates-formes de big data comme Apache Kudu. Le mécanisme de déclenchement de cache évite de solliciter la base de données source à chaque clic de l’utilisateur: TURBOARD surveille un champ de déclenchement désigné (tel qu'un horodatage mis à jour en dernier) et sert des résultats mis en cache de Redis lorsque les données sous-jacentes n'ont pas changé, interrogeant la source uniquement lorsque le déclencheur indique que de nouvelles données sont disponibles. Les fonctionnalités analytiques avancées restent entièrement disponibles, qu'un widget lise à partir du cache, du stockage colonnaire ou d'une source en direct. Un seul tableau de bord peut mélanger les trois sans compromis.
La perspicacité de Pareto, et le brevet qui la protège
Dans tout déploiement de BI d'entreprise, le comportement de l'utilisateur suit un schéma prévisible. Environ 80% des utilisateurs reviennent à plusieurs reprises sur les mêmes tableaux de bord de base — résumés exécutifs, rapports mensuels de performance, groupes régionaux. Les 20% restants sont des utilisateurs avancés exécutant des requêtes ad-hoc qui peuvent ne plus jamais être exécutées dans la même forme. L'implication pour la gestion de la mémoire est directe: tous les résultats mis en cache ne sont pas tout aussi précieux, et un système qui les traite comme équivalent gaspille sa ressource la plus coûteuse.
Le modèle d’expulsion de Qlik est comportement-aveugle. Les résultats mis en cache sont supprimés en fonction de l'âge, de la taille et du temps de calcul d'origine, et non en fonction de la fréquence à laquelle les utilisateurs réels les demandent réellement. Lorsque la mémoire se remplit, le moteur ne peut pas distinguer le tableau de bord que toute l'équipe de direction vérifie chaque matin d’une requête ponctuelle récemment mise en cache.
TURBOARD adopte l'approche inverse. Chaque fois qu'un rapport est consulté, son score de popularité est incrémenté dans un ensemble trié Redis - une structure de données conçue pour exactement ce type de modèle d'accès classé. Le système maintient un classement continuellement actualisé des rapports réellement utilisés, et utilise ce classement pour décider ce qui reste dans le cache lorsque la mémoire se raréfie. Les rapports les plus demandés sont protégés dans Redis, où ils reviennent sans latence à la majorité des utilisateurs qui en dépendent. Les requêtes Power-user qui manquent le cache sont acheminées vers la stockage colonnaire ou la source en direct – qui sont toutes deux conçues pour répondre à ces requêtes rapidement sans déplacer de contenu en cache de grande valeur.
Système d'affichage de résultat de recherche rapide alimenté par l'intelligence artificielle avec adaptation aux habitudes des utilisateurs
Ce mécanisme fait l'objet d'un brevet délivré. Le système a été déposé par E-Kalite (la société mère de TURBOARD) en 2022 et accordé en 2025. Le brevet couvre la méthode d'accélération de l'affichage des données sur l'interface utilisateur, de raccourcir les temps de chargement des entrées/sorties et de réduire la fréquence d'accès au matériel de stockage et de transmission de données - en d'autres termes, la combinaison de la notation basée sur l'utilisation, d'un rafraîchissement intelligent du cache et d'une détection des données périmées basée sur les déclencheurs qui permet à TURBOARD de servir des charges de travail d'entreprise sur des budgets de mémoire.
Le point stratégique est simple: lorsque la mémoire est abondante, la mise en cache comportement-aveugle vous coûte de l'efficacité. Lorsque la mémoire est rare, cela vous coûte de la performance.
Côte à côte
| Question | Approche Qlik Sense | Approche TURBOARD |
|---|---|---|
| Où vivent les données à l'exécution ? | En RAM, en entier | Dans un stockage colonnaire ou une source en direct ; résultats mis en cache sélectivement dans Redis |
| Que se passe-t-il lorsque la mémoire se remplit ? | Éviction de cache par âge/taille, puis fichier d’échange | Conservation selon le score d’utilisation ; autres requêtes traitées par le stockage colonnaire ou la source en direct |
| Comment l'utilisation répétée est-elle traitée? | Cache de résultat en mémoire, expulsé aveuglément | Cache Redis, conservé par le score d'utilisation (breveté) |
| Comment la fraîcheur des données est-elle maintenue ? | Recharges complètes ou QVD-incrémentales dans la RAM | Chargements incrémentiels du stockage colonnaire + déclencheurs de cache |
| Comment les requêtes en direct sont-elles traitées? | Découverte directe, avec des limites documentées | Pilotes natifs, analyses complètes conservées |
| Philosophie de mise à l’échelle | Allouer davantage de mémoire | Utilisez la mémoire de manière sélective, acheminez le reste |
Conclusion
Qlik Sense reste une plate-forme d'analyse en mémoire capable, et dans les conditions pour lesquelles elle a été conçue - ensembles de données bornés, concurrence prévisible, provisionnement de mémoire généreux - elle fonctionne bien. La question à laquelle ce post a essayé de répondre est ce qui se passe à mesure que ces conditions deviennent plus difficiles à respecter. Les volumes de données ne se réduisent pas. Les exigences en matière d’utilisateurs simultanés ne diminuent pas. Et le coût et la disponibilité de la mémoire, pour la première fois depuis longtemps, se déplacent dans la mauvaise direction.
L’architecture de TURBOARD fait le pari que la prochaine décennie de performance BI sera gagnée par les plateformes qui utilisent la mémoire intelligemment plutôt qu’en abondance. L’accès hybride aux données, le stockage colonnaire, les connexions natives aux sources et un cache breveté fondé sur un score d’utilisation permettent à TURBOARD d’offrir des performances d’entreprise avec des budgets mémoire difficiles à respecter pour les architectures entièrement en mémoire.
Pour les organisations confrontées à la collision de données croissantes, à l’augmentation de la concurrence et au resserrement de l’économie du matériel, cette différence d’approche n’est plus académique. C’est la différence entre une plate-forme qui évolue avec l’entreprise et une plate-forme qui évolue avec le budget d’approvisionnement.
Prêt à voir la différence ?
Si vous évaluez Qlik Sense – ou si vous l’exécutez déjà et que vous commencez à ressentir la pression de la mémoire décrite dans ce post – nous aimerions vous montrer comment l’architecture hybride de TURBOARD gère les mêmes charges de travail.
Réservez une présentation avec notre équipe et voyez la plate-forme en action avec vos propres données. Pas de pression – nous préférerions que vous trouviez le bon choix pour vos besoins spécifiques.
Vous pouvez aussi consulter notre page de comparaison complète de la BI pour voir comment nous nous positionnons dans d’autres scénarios d’entreprise.
Blogs



Apportez une vraie question métier. Voyez comment TURBOARD y répond.
Nous démontrons JAS sur vos rapports, vos définitions et votre contexte de sécurité — pas sur une base d’exemple générique.