Điều gì xảy ra với mô hình trong bộ nhớ của Qlik Sense khi RAM không còn rẻ hoặc có sẵn vô tận? Chúng tôi so sánh nó với kiến trúc lai của TURBOARD bằng cách sử dụng tài liệu riêng của Qlik và bằng sáng chế được cấp của chúng tôi về bộ nhớ đệm thông minh.
Trong hầu hết thập kỷ qua, các nền tảng kinh doanh thông minh được xây dựng trên một giả định thoải mái: bộ nhớ sẽ tiếp tục rẻ hơn, dày đặc hơn và dễ dàng hơn để ném vào các vấn đề. Giả định đó đang lặng lẽ phá vỡ. Việc xây dựng cơ sở hạ tầng AI đang hấp thụ một phần chưa từng có trong nguồn cung DRAM và HBM toàn cầu, và các nhà sản xuất bộ nhớ lớn đã cảnh báo rằng những hạn chế có khả năng sẽ sâu sắc hơn đến năm 2026. Đối với các nhóm BI doanh nghiệp, hiệu quả thực tế rất đơn giản - RAM mà nền tảng phân tích của bạn phụ thuộc vào đang trở nên đắt hơn, tranh cãi hơn và khó mở rộng quy mô theo yêu cầu.
Điều này thay đổi câu hỏi quan trọng.
Câu hỏi biểu diễn BI truyền thống là: Bảng điều khiển nhanh như thế nào khi tập dữ liệu phù hợp với bộ nhớ? Đó là câu hỏi mà các nhà cung cấp yêu thích, bởi vì câu trả lời hầu như luôn luôn “rất nhanh”. Nhưng nó không còn là câu hỏi quyết định liệu một nền tảng sẽ giữ vững trong sản xuất. Câu hỏi thực sự bây giờ là: Nền tảng hoạt động như thế nào khi khối lượng dữ liệu tăng lên, người dùng đồng thời nhân lên và bộ nhớ là tài nguyên bạn không thể mua thêm?
Câu hỏi đó có hai câu trả lời rất khác nhau trên thị trường hiện nay. Qlik Sense đại diện cho trường học trong bộ nhớ trưởng thành - tải mọi thứ vào RAM, giữ nó ở đó và để một động cơ liên kết cung cấp tốc độ thông qua sự gần gũi. TURBOARD đại diện cho một trường học lai - coi bộ nhớ như một lớp tăng tốc cho khối lượng công việc có lợi nhất và định tuyến mọi thứ khác đến lưu trữ cột hoặc các nguồn trực tiếp được thiết kế cho công việc.
Cả hai triết lý đều hoạt động. Câu hỏi thú vị là cái nào già đi tốt hơn khi các điều kiện xung quanh nó thay đổi. Bài đăng này đi qua những gì thực sự xảy ra với từng kiến trúc khi dữ liệu phát triển, người dùng tăng lên và RAM trở nên chặt chẽ - sử dụng tài liệu riêng của Qlik và kiến trúc được công bố của TURBOARD làm bằng chứng.
Hai kiến trúc, một thời gian ngắn
Qlik Sense được chế tạo xung quanh động cơ liên kết QIX. Khi một ứng dụng tải, tập dữ liệu chưa được tổng hợp được giữ trong RAM, cùng với các cấu trúc liên kết liên kết mọi giá trị với mọi giá trị khác. Lựa chọn người dùng được trả lời bằng cách đi qua các cấu trúc trong bộ nhớ đó và kết quả tính toán được lưu trong RAM để các yêu cầu giống hệt nhau tiếp theo trở lại ngay lập tức.
Định dạng QVD riêng của Qlik tăng tốc đáng kể lớp tải - báo cáo tài liệu Qlik QVD đọc nhanh hơn mười đến một trăm lần so với đọc từ các nguồn khác - nhưng mô hình thời gian chạy vẫn yêu cầu bộ dữ liệu làm việc để sống trong bộ nhớ vật lý.
TURBOARD đi theo một con đường khác. Dữ liệu có thể được truy cập thông qua các kết nối trực tiếp được tối ưu hóa bằng trình điều khiển cơ sở dữ liệu gốc hoặc được nhập vào cửa hàng cột hiệu suất cao như MariaDB ColumnStore, ClickHouse hoặc Vertica. Kết quả truy vấn được sử dụng thường xuyên được lưu trong Redis, kho lưu trữ cấu trúc dữ liệu trong bộ nhớ.
Một cơ chế kích hoạt bộ nhớ cache quyết định khi nào kết quả được lưu trong bộ nhớ cache vẫn còn hiệu lực và khi nào nguồn cần được truy vấn lại. Bộ nhớ được sử dụng một cách có chủ ý, cho khối lượng công việc mà nó tạo ra gia tốc nhiều nhất - không phải là nhà mặc định cho tất cả dữ liệu phân tích.
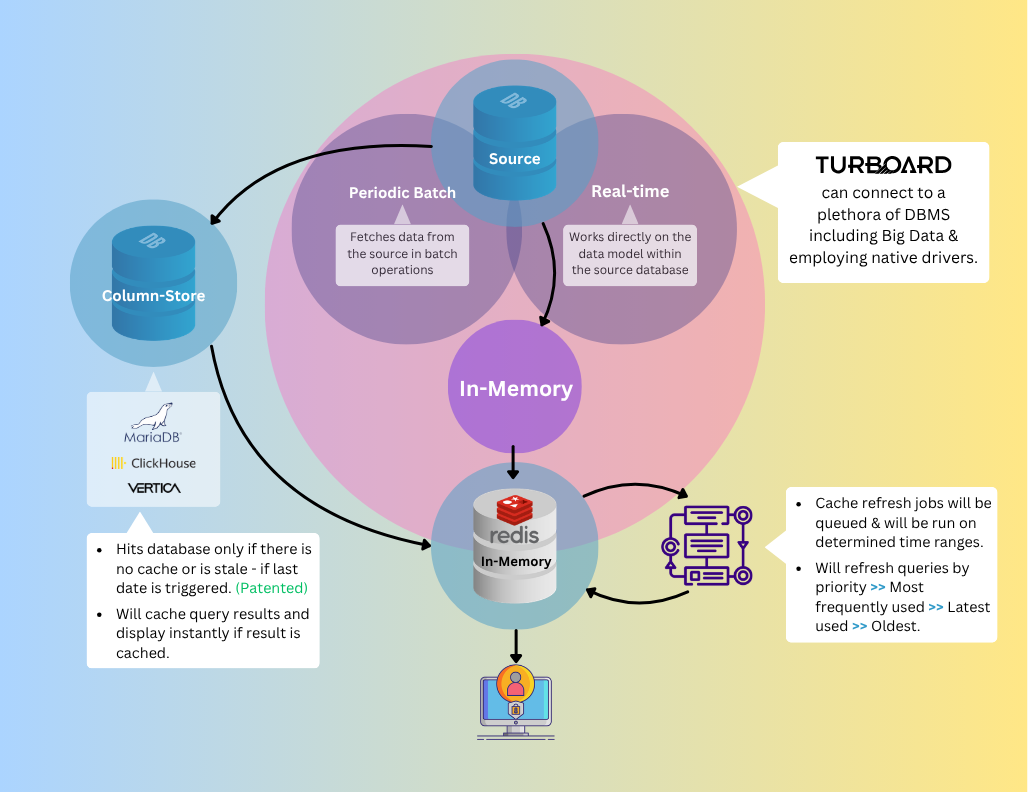
Sơ đồ trên cho thấy các lớp của TURBOARD phù hợp với nhau như thế nào. Phần còn lại của bài kiểm tra những gì mỗi kiến trúc làm khi các điều kiện xung quanh nó trở nên khó khăn hơn.
Kịch bản công bằng: khi trong ký ức thắng
Đáng để nói rõ ràng: khi tập dữ liệu phù hợp thoải mái trong RAM, khi đồng thời khiêm tốn và khi môi trường có kích thước cho ứng dụng, Qlik Sense thực sự nhanh. Công cụ liên kết là một phần kỹ thuật trưởng thành và trải nghiệm người dùng nhấp qua các bộ lọc và xem các tập hợp tính toán lại trong mili giây là, vào ngày của nó, tuyệt vời. Đối với việc triển khai bộ phận, các ứng dụng phân tích tập trung và khối lượng công việc mà mô hình dữ liệu ổn định và được hiểu rõ, cách tiếp cận trong bộ nhớ là một thế mạnh thực sự.
Đây là kịch bản mà hầu hết các cuộc biểu tình sản phẩm được xây dựng xung quanh. Đó cũng là kịch bản cho bạn biết ít nhất về cách một nền tảng sẽ hoạt động một năm vào sản xuất, sau khi dữ liệu đã phát triển, cơ sở người dùng đã mở rộng và ba ứng dụng khác đã được triển khai trên cùng một máy chủ.
Kịch bản mở rộng quy mô: nơi các kiến trúc phân kỳ
Tài liệu hỗ trợ riêng của Qlik mô tả chi tiết mô hình bộ nhớ. Động cơ hoạt động chống lại hai ngưỡng có thể cấu hình được gọi là Bộ làm việc thấp và bộ làm việc cao, với giá trị mặc định là 70% và 90% RAM vật lý tương ứng. Dưới ngưỡng thấp, công cụ vẫn giữ kết quả tính toán được lưu trong bộ nhớ cache một cách tích cực, trên nguyên tắc bộ nhớ không sử dụng bị lãng phí bộ nhớ. Khi ngưỡng thấp được vượt qua, công cụ bắt đầu loại bỏ các kết quả được lưu trữ để nhường chỗ cho những cái mới, ưu tiên trục xuất theo độ tuổi, kích thước và thời gian tính toán ban đầu. Khi ngưỡng cao được vượt qua, bộ nhớ đệm có hiệu quả dừng lại và tệp trang của hệ điều hành có thể được tham gia để giữ cho động cơ tồn tại. Tài liệu của Qlik lưu ý rằng việc sử dụng tệp trang có thể làm giảm hiệu suất đáng kể.
Cơ chế của những gì xảy ra giữa các ngưỡng đó quan trọng hơn chính các ngưỡng. Mỗi kết quả được lưu trữ được đuổi ra là một tính toán sẽ cần phải được tính toán lại vào lần tiếp theo người dùng yêu cầu nó. Khi trục xuất tăng tốc, tải tính toán chuyển từ bộ nhớ sang CPU. Trong một môi trường đồng thời cao, nơi nhiều người dùng đồng thời kích hoạt các phép tính không còn câu trả lời được lưu trong bộ nhớ cache, CPU trở thành nút cổ chai mới - và không giống như áp suất bộ nhớ, áp suất CPU biểu hiện trực tiếp dưới dạng độ trễ có thể nhìn thấy của người dùng: bảng điều khiển treo, bộ lọc mất vài giây để áp dụng, các phiên thời gian ra ngoài.
Cách tiếp cận hybrid của TURBOARD phân phối tải khác nhau. Bộ dữ liệu chưa được tổng hợp không cần phải chiếm RAM, bởi vì cửa hàng columnar được thiết kế để trả lời các truy vấn phân tích hiệu quả từ đĩa - chỉ đọc các cột mà một truy vấn chạm vào, khai thác nén nặng và phục vụ các tập hợp ở tốc độ cần xử lý trong bộ nhớ một thập kỷ trước. Tải gia tăng giữ cho cửa hàng columnar tươi mà không buộc phải tải lại hoàn toàn lặp đi lặp lại, có nghĩa là người dùng trải nghiệm dữ liệu gần như trực tiếp mà không có chi phí bộ nhớ giữ bộ dữ liệu đầy đủ trong RAM. Bộ nhớ cache Redis sau đó tăng tốc các truy vấn được hưởng lợi nhiều nhất từ tăng tốc - trong bất kỳ triển khai doanh nghiệp thực sự nào, là một tập hợp con nhỏ của tổng khối lượng truy vấn. Phần tiếp theo giải thích tại sao.
Dữ liệu trực tiếp: vấn đề Khám phá trực tiếp
Câu trả lời của Qlik cho khối lượng công việc vượt quá bộ nhớ có sẵn là Direct Discovery, một chế độ trong đó các trường kích thước được tải vào bộ nhớ trong khi các trường đo vẫn còn trong cơ sở dữ liệu nguồn và được truy vấn theo yêu cầu. Mục đích thiết kế là hợp lý; những hạn chế được ghi lại là đáng kể.
Những hạn chế được ghi lại của Direct Discovery (trên các tài liệu trợ giúp của Qlik):
- Kết nối cơ sở dữ liệu chia sẻ đơn cho tất cả người dùng của một ứng dụng - có thể tràn ngập cơ sở dữ liệu nguồn dưới sự đồng thời cao.
- SQL được tạo ra không được tối ưu hóa; nối giữa các bảng trong bộ nhớ và bảng Khám phá trực tiếp có thể tạo ra các mệnh đề IN rất lớn làm gián đoạn bộ đệm truy vấn cơ sở dữ liệu.
- Một số khả năng phân tích cốt lõi không được hỗ trợ, bao gồm Phân tích tập hợp, Cố vấn thông tin chi tiết và Chế độ xem động.
- Không có sự phát triển nào được lên kế hoạch để giải quyết những hạn chế này, theo tuyên bố riêng của Qlik.
Đối với TURBOARD, kết nối trực tiếp không phải là một giải pháp thay thế cho áp suất bộ nhớ. Đây là một phần hạng nhất của kiến trúc. Trình điều khiển cơ sở dữ liệu gốc - thay vì các kết nối ODBC chung - cung cấp quyền truy cập trực tiếp, hiệu suất cao vào các hệ thống nguồn, bao gồm các nền tảng dữ liệu lớn như Apache Kudu. Cơ chế kích hoạt bộ nhớ cache ngăn cơ sở dữ liệu nguồn bị ảnh hưởng trên mọi nhấp chuột của người dùng: TURBOARD xem một trường kích hoạt được chỉ định (chẳng hạn như dấu thời gian được cập nhật cuối cùng) và phục vụ các kết quả được lưu trong bộ nhớ cache từ Redis khi dữ liệu cơ bản không thay đổi, chỉ truy vấn nguồn khi trình kích hoạt cho biết dữ liệu mới có sẵn. Các tính năng phân tích nâng cao vẫn hoàn toàn có sẵn cho dù một tiện ích đang đọc từ bộ nhớ cache, từ cửa hàng cột hoặc từ một nguồn trực tiếp. Một bảng điều khiển duy nhất có thể kết hợp cả ba mà không cần thỏa hiệp.
Cái nhìn sâu sắc của Pareto, và bằng sáng chế bảo vệ nó
Trong bất kỳ triển khai BI doanh nghiệp nào, hành vi của người dùng tuân theo một mô hình có thể dự đoán được. Khoảng 80% người dùng quay lại nhiều lần vào cùng một bảng điều khiển cốt lõi - tóm tắt điều hành, báo cáo hiệu suất hàng tháng, triển khai khu vực. 20% còn lại là người dùng nguồn chạy các truy vấn đặc biệt có thể không bao giờ chạy lại dưới dạng tương tự. Hàm ý cho quản lý bộ nhớ là trực tiếp: không phải tất cả các kết quả được lưu trữ đều có giá trị như nhau và một hệ thống coi chúng tương đương là lãng phí tài nguyên đắt nhất của nó.
Mô hình trục xuất của Qlik là mù hành vi. Kết quả được lưu trữ được loại bỏ dựa trên độ tuổi, kích thước và thời gian tính toán ban đầu - không dựa trên tần suất người dùng thực tế thực sự yêu cầu chúng. Khi bộ nhớ lấp đầy, công cụ không thể phân biệt bảng điều khiển mà toàn bộ nhóm điều hành kiểm tra mỗi buổi sáng từ một truy vấn một lần đã xảy ra được lưu trữ gần đây.
TURBOARD có cách tiếp cận ngược lại. Mỗi khi một báo cáo được xem, điểm phổ biến của nó được tăng lên trong một Bộ phân loại màu đỏ - một cấu trúc dữ liệu được thiết kế cho chính xác loại mẫu truy cập được xếp hạng này. Hệ thống duy trì một bảng xếp hạng liên tục trong đó các báo cáo thực sự đang được sử dụng và sử dụng bảng xếp hạng đó để quyết định những gì vẫn còn trong bộ nhớ cache khi bộ nhớ chặt chẽ. Các báo cáo được yêu cầu nhiều nhất được bảo vệ trong Redis, nơi chúng trở lại với độ trễ bằng không cho phần lớn người dùng phụ thuộc vào chúng. Các truy vấn của người dùng nguồn bỏ lỡ bộ nhớ cache được chuyển đến cửa hàng cột hoặc nguồn trực tiếp - cả hai đều được thiết kế để trả lời các truy vấn đó một cách nhanh chóng mà không thay thế nội dung được lưu trữ có giá trị cao.
Hệ thống hiển thị kết quả tìm kiếm nhanh bằng trí tuệ nhân tạo với sự thích ứng với thói quen của người dùng
Cơ chế này là chủ đề của một bằng sáng chế được cấp. Hệ thống này đã được E-Kalite (công ty mẹ của TURBOARD) đệ trình vào năm 2022 và được cấp vào năm 2025. Bằng sáng chế bao gồm phương pháp tăng tốc hiển thị dữ liệu trên giao diện người dùng, rút ngắn thời gian tải đầu vào / đầu ra và giảm tần suất truy cập vào phần cứng lưu trữ dữ liệu và truyền dữ liệu - nói cách khác, sự kết hợp của tính điểm dựa trên sử dụng, làm mới bộ nhớ cache thông minh và phát hiện độ trễ dựa trên kích hoạt cho phép TURBOARD phục vụ khối lượng công việc doanh nghiệp trên ngân sách bộ nhớ sẽ đẩy các kiến trúc hoàn toàn trong bộ nhớ vào lãnh thổ trang.
Điểm chiến lược rất đơn giản: khi bộ nhớ là phong phú, hành vi mù bộ nhớ đệm chi phí bạn hiệu quả. Khi bộ nhớ khan hiếm, bạn phải trả giá bằng hiệu suất.
Cạnh nhau
| Câu hỏi | Cách tiếp cận cảm giác Qlik | Phương pháp tiếp cận TURBOARD |
|---|---|---|
| Dữ liệu sống ở đâu trong thời gian chạy? | Trong RAM, đầy đủ | Trong cửa hàng cột hoặc nguồn trực tiếp; kết quả được lưu trữ có chọn lọc trong Redis |
| Điều gì xảy ra khi bộ nhớ lấp đầy? | Cache trục xuất theo tuổi/kích thước, sau đó pagefile | Lưu giữ được ghi điểm hành vi; tràn được phục vụ từ cột hoặc nguồn trực tiếp |
| Việc sử dụng lặp lại được xử lý như thế nào? | Bộ nhớ cache kết quả trong bộ nhớ, bị đuổi một cách mù quáng | Bộ nhớ cache Redis, được giữ lại bằng điểm sử dụng (được cấp bằng sáng chế) |
| Độ tươi dữ liệu được duy trì như thế nào? | Tải lại đầy đủ hoặc QVD-incremental vào RAM | Tải cột tăng dần + bộ kích hoạt bộ nhớ cache |
| Các truy vấn trực tiếp được xử lý như thế nào? | Khám phá trực tiếp, với giới hạn tài liệu | Trình điều khiển bản địa, phân tích đầy đủ được giữ lại |
| Quy mô triết học | Cung cấp thêm bộ nhớ | Sử dụng bộ nhớ một cách chọn lọc, định tuyến phần còn lại |
Kết luận
Qlik Sense vẫn là một nền tảng phân tích trong bộ nhớ có khả năng và trong các điều kiện mà nó được thiết kế cho - các bộ dữ liệu giới hạn, đồng thời có thể dự đoán, cung cấp bộ nhớ hào phóng - nó hoạt động tốt. Câu hỏi mà bài đăng này đã cố gắng trả lời là điều gì xảy ra khi những điều kiện đó trở nên khó đáp ứng hơn. Khối lượng dữ liệu không bị thu hẹp. Kỳ vọng đồng thời không được thư giãn. Và chi phí và tính khả dụng của bộ nhớ, lần đầu tiên trong một thời gian dài, đang đi sai hướng.
Kiến trúc của TURBOARD là một đặt cược rằng thập kỷ tiếp theo của hiệu suất BI sẽ giành được bởi các nền tảng mà sử dụng trí nhớ một cách thông minh hơn là dồi dào. Truy cập dữ liệu kết hợp, lưu trữ cột, kết nối trực tiếp gốc và bộ nhớ cache được cấp bằng sáng chế cho phép TURBOARD cung cấp hiệu suất quy mô doanh nghiệp trên ngân sách bộ nhớ mà các kiến trúc trong ký ức hoàn toàn phải vật lộn để sống bên trong.
Đối với các tổ chức phải đối mặt với sự va chạm của dữ liệu ngày càng tăng, đồng thời gia tăng và thắt chặt kinh tế phần cứng, sự khác biệt trong cách tiếp cận đó không còn là học thuật. Đó là sự khác biệt giữa một nền tảng có quy mô với doanh nghiệp và một nền tảng có quy mô với ngân sách mua sắm.
Sẵn sàng để thấy sự khác biệt?
Nếu bạn đang đánh giá Qlik Sense – hoặc đã chạy nó và bắt đầu cảm nhận được áp lực bộ nhớ được mô tả trong bài đăng này – chúng tôi muốn cho bạn thấy kiến trúc lai của TURBOARD xử lý cùng một khối lượng công việc như thế nào.
Đặt một hướng dẫn với nhóm của chúng tôi và xem nền tảng đang hoạt động với dữ liệu của riêng bạn. Không có áp lực - chúng tôi muốn bạn tìm thấy sự phù hợp phù hợp với nhu cầu cụ thể của bạn.
Bạn cũng có thể khám phá của chúng tôi So sánh BI đầy đủ trang để xem cách chúng tôi xếp chồng lên nhau trên nhiều tình huống doanh nghiệp hơn nữa.
Blog




Mang đến một câu hỏi kinh doanh thực sự. Xem TURBOARD trả lời ra sao.
Chúng tôi trình diễn JAS trên báo cáo của bạn, định nghĩa của bạn và ngữ cảnh bảo mật của bạn — không phải trên cơ sở dữ liệu mẫu chung chung.