Cosa succede al modello in-memory di Qlik Sense quando la RAM non è più economica o disponibile all’infinito? Lo confrontiamo con l'architettura ibrida di TURBOARD utilizzando la documentazione di Qlik e il nostro brevetto concesso sulla memorizzazione nella cache intelligente.
Per la maggior parte dell'ultimo decennio, le piattaforme di business intelligence sono state costruite su un presupposto confortevole: la memoria continuerebbe a diventare più economica, più densa e più facile da lanciare contro i problemi. Questa ipotesi si sta tranquillamente rompendo. Gli edifici delle infrastrutture di intelligenza artificiale stanno assorbendo una quota senza precedenti della fornitura globale di DRAM e HBM e i principali produttori di memoria hanno avvertito che è probabile che i vincoli si approfondiscano fino al 2026. Per i team di BI aziendali, l'effetto pratico è semplice: la RAM da cui dipende la tua piattaforma di analisi sta diventando più costosa, più contestata e più difficile da scalare su richiesta.
Questo cambia la domanda che conta.
La tradizionale domanda di performance della BI era: quanto è veloce la dashboard quando il set di dati si adatta in memoria? È la domanda che i venditori amano, perché la risposta è quasi sempre “molto veloce”. Ma non è più la domanda che decide se una piattaforma reggerà nella produzione. La vera domanda ora è: Come si comporta la piattaforma quando i volumi di dati crescono, gli utenti simultanei si moltiplicano e la memoria è la risorsa di cui non puoi semplicemente acquistare di più?
Questa domanda ha due risposte molto diverse sul mercato oggi. Qlik Sense rappresenta la scuola di memoria matura: carica tutto in RAM, mantienilo lì e lascia che un motore associativo fornisca velocità attraverso la vicinanza. TURBOARD rappresenta una scuola ibrida: tratta la memoria come un livello di accelerazione per i carichi di lavoro che ne beneficiano di più e indirizza tutto il resto allo storage colonnare o alle fonti live progettate per il lavoro.
Entrambe le filosofie funzionano. La domanda interessante è quale invecchia meglio come le condizioni intorno ad esso cambiano. Questo post attraversa ciò che effettivamente accade a ciascuna architettura mentre i dati crescono, gli utenti aumentano e la RAM si stringe, utilizzando la documentazione di Qlik e l'architettura pubblicata da TURBOARD come prova.
Due architetture, brevemente
Qlik Sense è costruito attorno al motore associativo QIX. Quando un'applicazione viene caricata, il set di dati non aggregato viene tenuto in RAM, insieme alle strutture associative che collegano ogni valore a ogni altro valore. Le selezioni degli utenti ricevono l'attraversamento di tali strutture in memoria e i risultati di calcolo vengono memorizzati nella cache nella RAM, quindi le richieste identiche successive ritornano istantaneamente.
Il formato QVD di Qlik accelera drasticamente il livello di caricamento - la documentazione Qlik riporta che QVD si legge da dieci a cento volte più velocemente rispetto alle letture da altre fonti, ma il modello di runtime richiede comunque che il set di dati di lavoro viva in memoria fisica.
TURBOARD prende una strada diversa. I dati possono essere accessibili attraverso connessioni live ottimizzate utilizzando driver di database nativi o importati in un negozio colonnare ad alte prestazioni come MariaDB ColumnStore, ClickHouse o Vertica. I risultati delle query utilizzati frequentemente sono memorizzati nella cache di Redis, l'archivio della struttura dei dati in memoria.
Un meccanismo di trigger della cache decide quando i risultati memorizzati nella cache sono ancora validi e quando la sorgente deve essere ri-queried. La memoria viene utilizzata deliberatamente, per i carichi di lavoro in cui produce la maggior accelerazione, non come la casa predefinita per tutti i dati analitici.
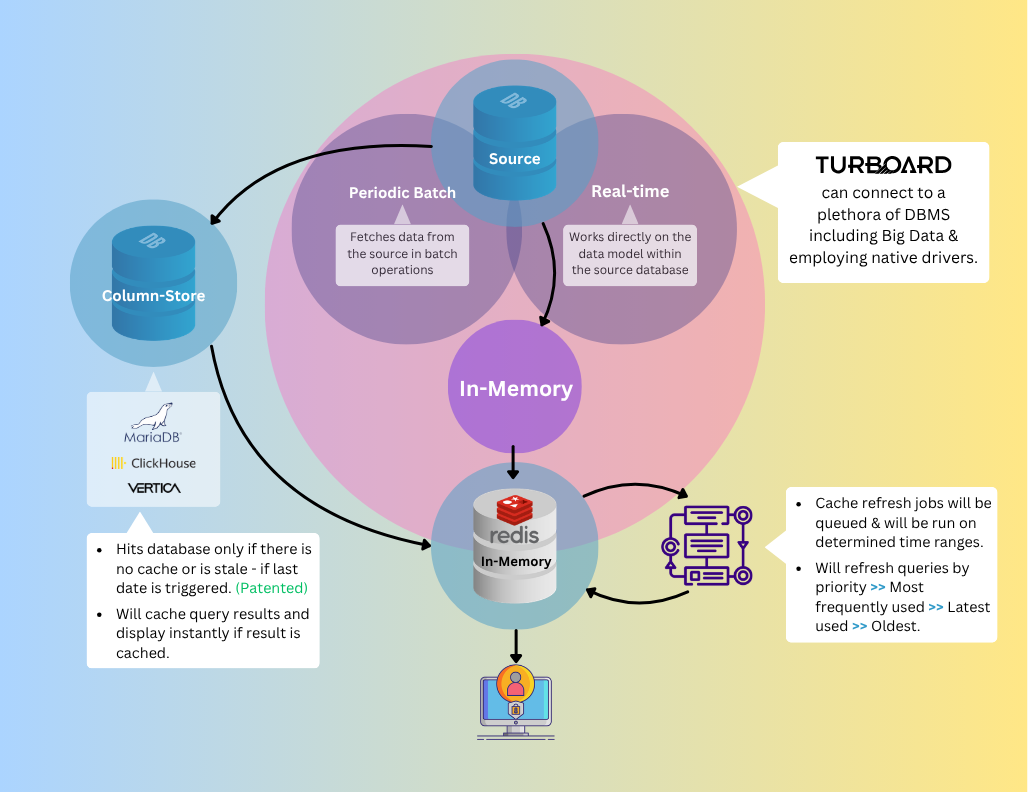
Il diagramma sopra mostra come gli strati di TURBOARD si incastrano insieme. Il resto del post esamina ciò che ogni architettura fa mentre le condizioni intorno diventano più difficili.
Lo scenario giusto: quando vince la memoria
Vale la pena di dire chiaramente: quando il set di dati si adatta comodamente alla RAM, quando la concorrenza è modesta e quando l'ambiente è dimensionato per l'applicazione, Qlik Sense è veramente veloce. Il motore associativo è un pezzo di ingegneria maturo, e l'esperienza utente di fare clic attraverso filtri e guardare le aggregazioni ricalcolare in millisecondi è, nel suo giorno, eccellente. Per le distribuzioni dipartimentali, le applicazioni analitiche focalizzate e i carichi di lavoro in cui il modello di dati è stabile e ben compreso, l'approccio in-memory è un vero punto di forza.
Questo è lo scenario in cui la maggior parte delle dimostrazioni di prodotto sono costruite intorno. È anche lo scenario che ti dice il minimo su come una piattaforma si comporterà un anno in produzione, dopo che i dati sono cresciuti, la base di utenti si è espansa e altre tre applicazioni sono state distribuite sullo stesso server.
Lo scenario di scala: dove le architetture divergono
La documentazione di supporto di Qlik descrive il modello di memoria in dettaglio. Il motore funziona a fronte di due soglie configurabili note come Set di lavoro basso e set di lavoro elevato, con valori predefiniti del 70% e 90% della RAM fisica rispettivamente. Al di sotto della soglia bassa, il motore conserva i risultati di calcolo memorizzati nella cache in modo aggressivo, secondo il principio che la memoria non utilizzata è memoria sprecata. Una volta superata la soglia bassa, il motore inizia a sfrattare i risultati memorizzati nella cache per fare spazio a quelli nuovi, dando priorità allo sfratto per età, dimensioni e tempo di calcolo originale. Una volta superata la soglia elevata, la memorizzazione nella cache si arresta efficacemente e il file di pagina del sistema operativo può essere coinvolto per mantenere vivo il motore. La documentazione di Qlik rileva che l'uso del file di pagina può degradare le prestazioni in modo significativo.
La meccanica di ciò che accade tra quelle soglie conta più delle soglie stesse. Ogni risultato memorizzato nella cache che viene sfrattato è un calcolo che dovrà essere ricalcolato la prossima volta che un utente lo richiede. Man mano che lo sfratto accelera, il carico computazionale si sposta dalla memoria alla CPU. In un ambiente ad alta concorrenza, in cui molti utenti stanno attivando contemporaneamente calcoli che non hanno più risposte memorizzate nella cache, la CPU diventa il nuovo collo di bottiglia - e a differenza della pressione della memoria, la pressione della CPU si manifesta direttamente come latenza visibile dall'utente: dashboard che si appendono, filtri che richiedono secondi per applicarsi, sessioni che si trovano.
L’approccio ibrido di TURBOARD distribuisce il carico in modo diverso. Il set di dati non aggregato non ha bisogno di occupare la RAM, perché il negozio colonnare è progettato per rispondere a query analitiche in modo efficiente da disco — leggere solo le colonne che una query tocca, sfruttare la compressione pesante e servire aggregazioni a velocità che avrebbero richiesto l'elaborazione in memoria di un decennio fa. Il caricamento incrementale mantiene il negozio colonnare fresco senza forzare ripetuti ricarichi completi, il che significa che gli utenti sperimentano dati near-live senza il costo della memoria di tenere il set di dati completo in RAM. La cache Redis accelera quindi le query che beneficiano maggiormente dell'accelerazione, che, in qualsiasi distribuzione aziendale reale, è un piccolo sottoinsieme di volume totale di query. La sezione successiva spiega il perché.
Dati in diretta: il problema Direct Discovery
La risposta di Qlik ai carichi di lavoro che superano la memoria disponibile è Direct Discovery, una modalità in cui i campi di dimensione vengono caricati in memoria mentre i campi di misura rimangono nel database di origine e vengono interrogati su richiesta. L'intento progettuale è ragionevole; le limitazioni documentate sono significative.
Limitazioni documentate di Direct Discovery (per i materiali di aiuto di Qlik):
- Connessione a database condivisi singoli per tutti gli utenti di un'applicazione - può inondare il database di origine in alta concorrenza.
- L'SQL generato non è ottimizzato; joins tra tabelle in-memory e Direct Discovery tabelle possono produrre clausole IN molto grandi che mettono a dura prova i buffer di query del database.
- Diverse capacità analitiche fondamentali non sono supportate, include Set Analysis, Insight Advisor e Dynamic Views.
- Non è previsto alcun ulteriore sviluppo per affrontare queste limitazioni, secondo la dichiarazione di Qlik.
Per TURBOARD, la connettività dal vivo non è una soluzione alternativa per la pressione della memoria. È una parte di prima classe dell’architettura. I driver di database nativi - piuttosto che le connessioni ODBC generiche - forniscono un accesso diretto e ad alte prestazioni ai sistemi di origine, comprese le piattaforme di big data come Apache Kudu. Il meccanismo di trigger della cache impedisce che il database di origine venga colpito su ogni clic dell'utente: TURBOARD guarda un campo di trigger designato (ad esempio un timestamp aggiornato l'ultimo) e serve i risultati memorizzati nella cache di Redis quando i dati sottostanti non sono cambiati, interrogando l'origine solo quando il trigger indica che sono disponibili dati freschi. Le funzionalità analitiche avanzate rimangono completamente disponibili sia che un widget stia leggendo dalla cache, dal negozio colonnare o da una fonte live. Un singolo cruscotto può mescolare tutti e tre senza compromessi.
L'intuizione di Pareto e il brevetto che la protegge
In qualsiasi distribuzione di BI aziendale, il comportamento dell'utente segue un modello prevedibile. Circa l'80% degli utenti ritorna ripetutamente alle stesse dashboard di base — riassunti esecutivi, rapporti mensili sulle prestazioni, rollup regionali. Il restante 20% sono utenti esperti che eseguono query ad hoc che potrebbero non essere mai più eseguite nella stessa forma. L'implicazione per la gestione della memoria è diretta: non tutti i risultati memorizzati nella cache sono ugualmente preziosi e un sistema che li tratta come equivalenti sta sprecando la sua risorsa più costosa.
Il modello di sfratto di Qlik è cieco per il comportamento. I risultati memorizzati nella cache vengono rimossi in base all'età, alle dimensioni e al tempo di calcolo originale, non in base alla frequenza con cui gli utenti effettivi li richiedono effettivamente. Quando la memoria si riempie, il motore non può distinguere il cruscotto che l'intero team esecutivo controlla ogni mattina da una query una tantum che è stata memorizzata nella cache di recente.
TURBOARD adotta l'approccio opposto. Ogni volta che viene visualizzato un report, il suo punteggio di popolarità viene incrementato in un set ordinato Redis, una struttura di dati progettata esattamente per questo tipo di modello di accesso classificato. Il sistema mantiene una classifica continua di cui vengono effettivamente utilizzati i rapporti e utilizza quella classifica per decidere cosa rimane nella cache quando la memoria è stretta. I rapporti più richiesti sono protetti in Redis, dove ritornano con zero latenza alla maggior parte degli utenti che dipendono da loro. Le query dell'utente di alimentazione che mancano alla cache vengono indirizzate al negozio colonnare o alla sorgente live, entrambe progettate per rispondere rapidamente a tali query senza spostare contenuti di cache di alto valore.
Sistema di visualizzazione rapida dei risultati di ricerca basata sull'intelligenza artificiale con adattamento alle abitudini degli utenti
Questo meccanismo è oggetto di un brevetto concesso. Il sistema è stato depositato da E-Kalite (società madre di TURBOARD) nel 2022 e concesso nel 2025. Il brevetto copre il metodo di accelerazione della visualizzazione dei dati sull'interfaccia utente, l'accorciamento dei tempi di caricamento di input / output e la riduzione della frequenza di accesso all'hardware di memorizzazione dei dati e trasmissione dei dati, in altre parole, la combinazione di punteggio basato sull'utilizzo, aggiornamento intelligente della cache e rilevamento di stallo basato su trigger che consente a TURBOARD di servire carichi di lavoro aziendali sui budget di memoria che spingerebbero le architetture puramente in memoria nel territorio del file di pagina.
Il punto strategico è semplice: quando la memoria è abbondante, il caching callo-campo-comportamento ti costa l'efficienza. Quando la memoria è scarsa, ti costa le prestazioni.
Fianco a fianco
| Domanda | Approccio Qlik Sense | Approccio TURBOARD |
|---|---|---|
| Dove vivono i dati in fase di runtime? | In RAM, in pieno | Nel negozio colonnare o nella fonte live; risultati memorizzati nella cache selettivamente in Redis |
| Cosa succede quando la memoria si riempie? | Cache sfratto per età/dimensione, poi pagefile | Ritenzione con punteggio di comportamento; overflow servito da sorgente colonnare o live |
| Come viene gestito l'uso ripetuto? | Cache dei risultati in memoria, sfrattata ciecamente | Redis cache, mantenuto dal punteggio di utilizzo (brevettato) |
| Come viene mantenuta la freschezza dei dati? | Ricariche complete o incrementali QVD in RAM | Carichi colonnari incrementali + trigger di cache |
| Come vengono gestite le query live? | Discovery diretto, con limiti documentati | Driver nativi, l'analisi completa mantenuta |
| Scalare la filosofia | Fornire più memoria | Usa la memoria in modo selettivo, instrada il resto |
Conclusione
Qlik Sense rimane una piattaforma di analisi in-memory capace, e nelle condizioni per cui è stata progettata - set di dati delimitati, concorrente prevedibile, generoso provisioning della memoria - funziona bene. La domanda a cui questo post ha cercato di rispondere è cosa succede quando quelle condizioni diventano più difficili da soddisfare. I volumi di dati non si stanno riducendo. Le aspettative di concorrenza non si rilassano. E il costo e la disponibilità della memoria, per la prima volta dopo tanto tempo, si stanno muovendo nella direzione sbagliata.
L’architettura di TURBOARD è una scommessa che il prossimo decennio di prestazioni della BI sarà vinto da piattaforme che usare la memoria in modo intelligente piuttosto che abbondante. L'accesso ai dati ibridi, l'archiviazione colonnare, la connettività live nativa e una cache brevettata con punteggio di utilizzo consentono a TURBOARD di offrire prestazioni su scala aziendale sui budget di memoria che le architetture puramente in-memory faticano a vivere all'interno.
Per le organizzazioni che affrontano la collisione di dati crescenti, l'aumento della concorrenza e il rafforzamento dell'economia hardware, questa differenza di approccio non è più accademica. È la differenza tra una piattaforma che scala con il business e una piattaforma che scala con il budget di approvvigionamento.
Pronti a vedere la differenza?
Se stai valutando Qlik Sense - o già lo stai eseguendo e iniziando a sentire la pressione della memoria descritta in questo post - ci piacerebbe mostrarti come l'architettura ibrida di TURBOARD gestisce gli stessi carichi di lavoro.
Prenota una procedura con il nostro team e consulta la piattaforma in azione con i tuoi dati. Nessuna pressione: preferiremmo che trovassi la soluzione giusta per le tue esigenze specifiche.
Puoi anche esplorare il nostro Confronto BI completo pagina per vedere come ci impiliamo in scenari ancora più aziendali.
Blog




Porta una vera domanda di business. Guarda come risponde TURBOARD.
Dimostriamo JAS sui tuoi report, sulle tue definizioni e sul tuo contesto di sicurezza — non su un database di esempio generico.