Was passiert mit dem In-Memory-Modell von Qlik Sense, wenn RAM nicht mehr billig oder endlos verfügbar ist? Wir vergleichen es mit der Hybridarchitektur von TURBOARD mit der eigenen Dokumentation von Qlik und unserem erteilten Patent für intelligentes Caching.
Für den größten Teil des letzten Jahrzehnts basierten Business-Intelligence-Plattformen auf einer komfortablen Annahme: Der Speicher würde immer billiger, dichter und leichter auf Probleme zu werfen werden. Diese Annahme bricht leise. KI-Infrastruktur-Buildouts absorbieren einen beispiellosen Anteil der globalen DRAM- und HBM-Versorgung, und große Speicherhersteller haben davor gewarnt, dass sich die Einschränkungen bis 2026 verschärfen werden. Für BI-Teams ist der praktische Effekt einfach - der RAM, von dem Ihre Analyseplattform abhängt, wird teurer, umstrittener und bei Bedarf schwieriger zu skalieren.
Das ändert die Frage, die zählt.
Die traditionelle BI-Performance-Frage lautete: Wie schnell ist das Dashboard, wenn der Datensatz in den Speicher passt? Es ist die Frage, die die Verkäufer lieben, denn die Antwort ist fast immer „sehr schnell“. Aber es ist nicht mehr die Frage, ob eine Plattform in der Produktion Bestand haben wird. Die eigentliche Frage ist jetzt: Wie verhält sich die Plattform, wenn Datenmengen wachsen, gleichzeitige Benutzer multiplizieren und Speicher die Ressource ist, von der Sie nicht einfach mehr kaufen können?
Diese Frage hat heute zwei sehr unterschiedliche Antworten auf dem Markt. Qlik Sense repräsentiert die reife In-Memory-Schule - laden Sie alles in den RAM, halten Sie ihn dort und lassen Sie einen assoziativen Motor durch die Nähe schalten. TURBOARD repräsentiert eine hybride Schule - behandeln Sie das Gedächtnis als Beschleunigungsschicht für die Workloads, die am meisten profitieren, und leiten Sie alles andere an säulenförmige Speicher oder Live-Quellen weiter, die für den Job entwickelt wurden.
Beide Philosophien funktionieren. Die interessante Frage ist, welche besser altert, wenn sich die Bedingungen um sie herum ändern. Dieser Beitrag geht durch das, was tatsächlich mit jeder Architektur passiert, wenn die Daten wachsen, die Benutzer zunehmen und der RAM angespannt wird - mit Qliks eigener Dokumentation und der veröffentlichten Architektur von TURBOARD als Beweis.
Zwei Architekturen, kurz
Qlik Sense ist um den QIX-Assoziativmotor herum aufgebaut. Wenn eine Anwendung geladen wird, wird der nicht aggregierte Datensatz im RAM gehalten, zusammen mit den assoziativen Strukturen, die jeden Wert mit jedem anderen Wert verknüpfen. Benutzerauswahlen werden beantwortet, indem diese In-Memory-Strukturen durchlaufen werden, und die Berechnungsergebnisse werden im RAM zwischengespeichert, sodass nachfolgende identische Anfragen sofort zurückgegeben werden.
Das eigene QVD-Format von Qlik beschleunigt die Ladeschicht dramatisch - Qlik-Dokumentation berichtet, dass QVD zehn- bis hundertmal schneller liest als Lesevorgänge aus anderen Quellen -, aber das Laufzeitmodell erfordert immer noch, dass der Arbeitsdatensatz im physischen Speicher lebt.
TURBOARD geht einen anderen Weg. Daten können über optimierte Live-Verbindungen mit nativen Datenbanktreibern abgerufen oder in einen leistungsstarken columnaren Store wie MariaDB ColumnStore, ClickHouse oder Vertica importiert werden. Häufig verwendete Abfrageergebnisse werden in Redis, dem In-Memory-Datenstrukturspeicher, zwischengespeichert.
Ein Cache-Trigger-Mechanismus entscheidet, wann zwischengespeicherte Ergebnisse noch gültig sind und wann die Quelle erneut abgefragt werden muss. Der Speicher wird bewusst verwendet, für die Workloads, wo er die meiste Beschleunigung erzeugt - nicht als Standardhaus für alle analytischen Daten.
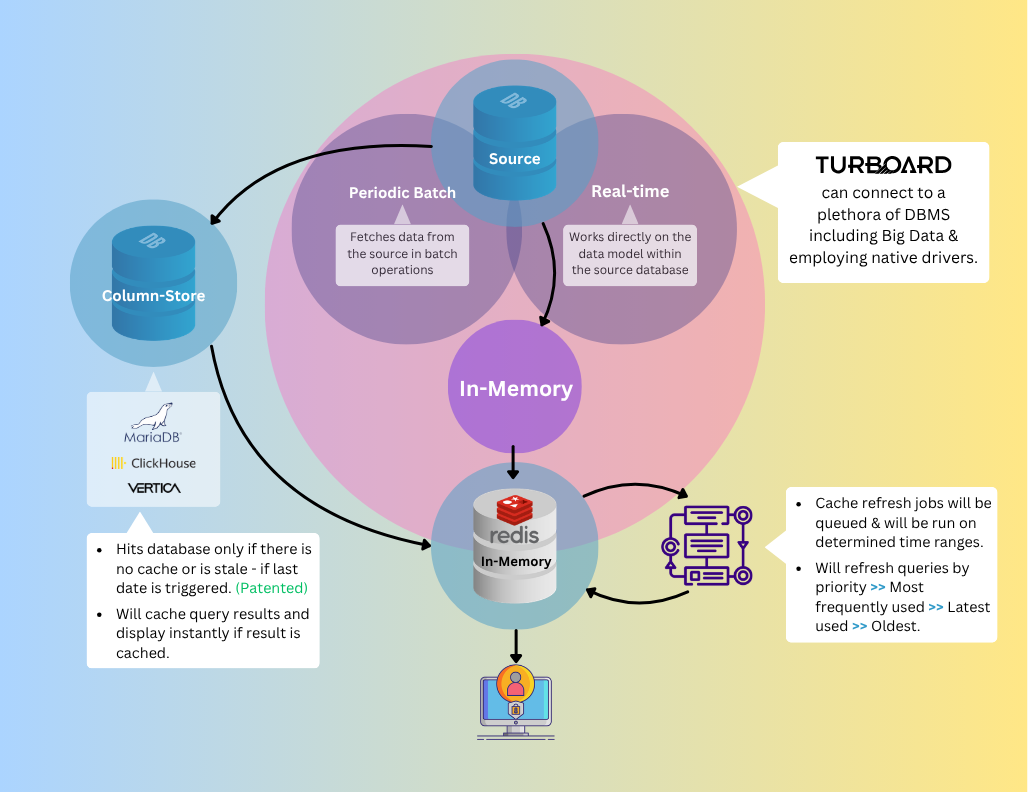
Das obige Diagramm zeigt, wie die Schichten von TURBOARD zusammenpassen. Der Rest des Beitrags untersucht, was jede Architektur tut, wenn die Bedingungen um sie herum schwieriger werden.
Das faire Szenario: Wenn In-Memory gewinnt
Es lohnt sich, klar zu sagen: Wenn der Datensatz bequem in RAM passt, wenn die Gleichzeitigkeit bescheiden ist und wenn die Umgebung für die Anwendung dimensioniert ist, ist Qlik Sense wirklich schnell. Der associative Motor ist ein ausgereiftes Stück Engineering, und die Benutzererfahrung, Filter durchzuklicken und Aggregationen in Millisekunden neu berechnen zu sehen, ist an seinem Tag hervorragend. Für Abteilungsbereitstellungen, fokussierte analytische Anwendungen und Workloads, bei denen das Datenmodell stabil und gut verstanden ist, ist der In-Memory-Ansatz eine echte Stärke.
Dies ist das Szenario, um das die meisten Produktdemonstrationen aufgebaut sind. Es ist auch das Szenario, das Ihnen am wenigsten sagt, wie sich eine Plattform ein Jahr nach dem Wachstum der Daten, der Benutzerbasis und drei weiteren Anwendungen auf demselben Server verhalten wird, in der Produktion verhalten wird.
Das Skalierungsszenario: Wo die Architekturen auseinandergehen
Die Qlik-eigene Support-Dokumentation beschreibt das Speichermodell im Detail. Der Motor arbeitet gegen zwei konfigurierbare Schwellenwerte, die als Arbeitssatz Niedrig und Arbeitssatz Hoch, mit Standardwerten von 70% und 90% des physischen RAM bzw. Unterhalb der niedrigen Schwelle behält die Engine zwischengespeicherte Berechnungsergebnisse aggressiv bei, nach dem Prinzip, dass ungenutzter Speicher verschwendeter Speicher ist. Sobald die niedrige Schwelle überschritten ist, beginnt die Engine, zwischengespeicherte Ergebnisse zu räumen, um Platz für neue zu schaffen, wobei die Räumung nach Alter, Größe und ursprünglicher Berechnungszeit priorisiert wird. Sobald die hohe Schwelle überschritten ist, stoppt das Zwischenspeichern effektiv, und die Seitendatei des Betriebssystems kann aktiviert werden, um den Motor am Leben zu erhalten. Die Dokumentation von Qlik weist darauf hin, dass die Verwendung von Seitendateien die Leistung erheblich beeinträchtigen kann.
Die Mechanik dessen, was zwischen diesen Schwellen passiert, ist wichtiger als die Schwellen selbst. Jedes zwischengespeicherte Ergebnis, das geräumt wird, ist eine Berechnung, die beim nächsten Mal, wenn ein Benutzer sie anfordert, neu berechnet werden muss. Wenn die Räumung beschleunigt wird, verschiebt sich die Rechenlast von Speicher zu CPU. In einer Umgebung mit hoher Übereinstimmung, in der viele Benutzer gleichzeitig Berechnungen auslösen, die keine zwischengespeicherten Antworten mehr haben, wird die CPU zum neuen Engpass - und im Gegensatz zum Speicherdruck manifestiert sich der CPU-Druck direkt als benutzerdefinierte Latenz: Dashboards, die hängen, Filter, die Sekunden dauern, Sitzungen, die aus sind.
Der hybride Ansatz von TURBOARD verteilt die Last unterschiedlich. Der nicht aggregierte Datensatz muss keinen RAM besetzen, da Der säulenförmige Speicher wurde entwickelt, um analytische Abfragen effizient von der Festplatte zu beantworten — nur die Spalten zu lesen, die eine Abfrage berührt, schwere Kompression ausnutzt und Aggregationen mit Geschwindigkeiten bedient, die vor einem Jahrzehnt eine In-Memory-Verarbeitung erfordert hätten. Das inkrementelle Laden hält den säulenförmigen Speicher frisch, ohne wiederholte vollständige Nachladungen zu erzwingen, was bedeutet, dass Benutzer nahezu lebende Daten ohne die Speicherkosten für das Halten des vollständigen Datensatzes im RAM erleben. Der Redis-Cache beschleunigt dann die Abfragen, die am meisten von der Beschleunigung profitieren – was bei jeder realen Unternehmensbereitstellung eine kleine Teilmenge des gesamten Abfragevolumens ist. Der nächste Abschnitt erklärt, warum.
Live-Daten: das Problem der Direktentdeckung
Qliks Antwort auf Workloads, die den verfügbaren Speicher übertreffen, ist Direct Discovery, ein Modus, in dem Dimensionsfelder in den Speicher geladen werden, während die Messfelder in der Quelldatenbank verbleiben und bei Bedarf abgefragt werden. Die Designabsicht ist angemessen; die dokumentierten Einschränkungen sind signifikant.
Dokumentierte Einschränkungen von Direct Discovery (pro Qliks eigene Hilfematerialien):
- Einzelne freigegebene Datenbankverbindung für alle Benutzer einer Anwendung - kann die Quelldatenbank unter hoher Parallelität überfluten.
- Generiertes SQL ist nicht optimiert; Verknüpfungen zwischen In-Memory-Tabellen und Direct Discovery-Tabellen können sehr große IN-Klauseln erzeugen, die Datenbankabfrage-Puffer belasten.
- Mehrere Kernanalysefähigkeiten werden unterstützt, einschließlich Set-Analyse, Insight Advisor und dynamische Ansichten.
- Eine weitere Entwicklung ist nicht geplant um diese Einschränkungen zu beheben, pro Qliks eigener Aussage.
Für TURBOARD ist Live-Konnektivität kein Workaround für den Speicherdruck. Es ist ein erstklassiger Teil der Architektur. Native Datenbanktreiber – anstatt generische ODBC-Verbindungen – bieten einen direkten, leistungsstarken Zugriff auf Quellsysteme, einschließlich Big-Data-Plattformen wie Apache Kudu. Der Cache-Trigger-Mechanismus verhindert, dass die Quelldatenbank bei jedem Benutzerklick getroffen wird: TURBOARD beobachtet ein bestimmtes Triggerfeld (z. B. einen zuletzt aktualisierten Zeitstempel) und serviert zwischengespeicherte Ergebnisse von Redis, wenn sich die zugrunde liegenden Daten nicht geändert haben, und fragt die Quelle nur ab, wenn der Trigger neue Daten anzeigt. Erweiterte analytische Funktionen bleiben vollständig verfügbar, unabhängig davon, ob ein Widget aus dem Cache, aus dem Säulenspeicher oder aus einer Live-Quelle liest. Ein einziges Dashboard kann alle drei ohne Kompromisse mischen.
Die Pareto-Einsicht und das Patent, das sie schützt
In jeder Enterprise-BI-Bereitstellung folgt das Benutzerverhalten einem vorhersehbaren Muster. Etwa 80% der Benutzer kehren wiederholt zu denselben Kern-Dashboards zurück — Zusammenfassungen der Führungskräfte, monatliche Leistungsberichte, regionale Rollups. Die restlichen 20% sind Power-User, die Ad-hoc-Abfragen ausführen, die möglicherweise nie wieder in derselben Form ausgeführt werden. Die Implikation für die Speicherverwaltung ist direkt: Nicht alle zwischengespeicherten Ergebnisse sind gleich wertvoll, und ein System, das sie als gleichwertig behandelt, verschwendet seine teuerste Ressource.
Qliks Räumungsmodell ist verhaltensblind. Zwischengespeicherte Ergebnisse werden basierend auf Alter, Größe und ursprünglicher Berechnungszeit entfernt - nicht basierend darauf, wie oft tatsächliche Benutzer sie tatsächlich anfordern. Wenn sich der Speicher füllt, kann die Engine das Dashboard, das das gesamte Führungsteam jeden Morgen überprüft, nicht von einer einmaligen Abfrage unterscheiden, die kürzlich zwischengespeichert wurde.
TURBOARD verfolgt den gegenteiligen Ansatz. Jedes Mal, wenn ein Bericht angesehen wird, wird sein Beliebtheitswert in einem Redis Sorted Set erhöht - einer Datenstruktur, die genau für diese Art von Ranked-Access-Muster entwickelt wurde. Das System unterhält eine kontinuierliche Rangliste, von der tatsächlich Berichte verwendet werden, und verwendet diese Rangliste, um zu entscheiden, was im Cache bleibt, wenn der Speicher knapp ist. Die am häufigsten nachgefragten Berichte sind in Redis geschützt, wo sie ohne Latenz an die Mehrheit der Benutzer zurückkehren, die von ihnen abhängig sind. Power-User-Abfragen, die den Cache verpassen, werden an den columnar store oder die Live-Quelle weitergeleitet – beide sind darauf ausgelegt, diese Abfragen schnell zu beantworten, ohne hochwertige zwischengespeicherte Inhalte zu verschieben.
Künstliches, auf Intelligenz ausgerichtetes Schnellsuchergebnis-Anzeigesystem mit Anpassung an Benutzergewohnheiten
Dieser Mechanismus ist Gegenstand eines erteilten Patents. Das System wurde 2022 von E-Kalite (die Muttergesellschaft von TURBOARD) eingereicht und 2025 erteilt. Das Patent umfasst das Verfahren zur Beschleunigung der Datenanzeige auf der Benutzeroberfläche, zur Verkürzung der Ein-/Ausgabeladezeiten und zur Verringerung der Zugriffshäufigkeit auf Datenspeicher- und Datenübertragungshardware – also der Kombination aus nutzungsbasiertem Scoring, intelligenter Cache-Refresh und trigger-based Staleness-Erkennung, mit der TURBOARD Enterprise-Workloads auf Speicherbudgets bedienen kann, die rein in-Memory-Architekturen ins Spiel bringen würden.
Der strategische Punkt ist einfach: Wenn das Gedächtnis reichlich vorhanden ist, kostet verhaltensblindes Caching die Effizienz. Wenn der Speicher knapp ist, kostet es die Leistung.
Seite an Seite
| Frage | Qlik Sense Ansatz | TURBOARD-Ansatz |
|---|---|---|
| Wo leben die Daten zur Laufzeit? | Im RAM, in voller Höhe | In columnar store oder live source; Ergebnisse selektiv in Redis zwischengespeichert |
| Was passiert, wenn sich der Speicher füllt? | Cache-Räumung nach Alter/Größe, dann Pagefile | Verhaltenswerte Retention; Überlauf aus säulenförmiger oder Live-Quelle |
| Wie wird die wiederholte Nutzung behandelt? | In-Memory-Ergebnis-Cache, blind vertrieben | Redis Cache, gespeichert durch Nutzungs-Score (patentiert) |
| Wie wird die Datenfrische erhalten? | Voll- oder QVD-inkrementelle Nachladungen in RAM | Inkrementelle säulenförmige Lasten + Cache-Trigger |
| Wie werden Live-Anfragen behandelt? | Direct Discovery mit dokumentierten Limits | Native Treiber, vollständige Analyse beibehalten |
| Skalierungsphilosophie | Bereitstellung von mehr Speicher | Verwenden Sie den Speicher selektiv, leiten Sie den Rest weiter |
Schlussfolgerung
Qlik Sense bleibt eine fähige In-Memory-Analyseplattform, und unter den Bedingungen, für die es entwickelt wurde - begrenzte Datensätze, vorhersehbare Parallelität, großzügige Speicherbereitstellung - funktioniert es gut. Die Frage, die dieser Beitrag zu beantworten versucht hat, ist, was passiert, wenn diese Bedingungen schwieriger zu erfüllen sind. Die Datenmengen schrumpfen nicht. Die Erwartungen an die Gleichzeitigkeit sind nicht entspannend. Und die Kosten und Verfügbarkeit von Speicher bewegen sich zum ersten Mal seit langem in die falsche Richtung.
Die Architektur von TURBOARD ist eine Wette, dass das nächste Jahrzehnt der BI-Performance von Plattformen gewonnen wird, die Verwenden Sie den Speicher intelligent und nicht reichlich. Hybrider Datenzugriff, säulenförmiger Speicher, native Live-Konnektivität und ein patentierter, mit der Nutzung bewerteter Cache ermöglichen es TURBOARD, eine Leistung in Unternehmensgröße für Speicherbudgets zu erbringen, in denen rein in-Memory-Architekturen Schwierigkeiten haben, darin zu leben.
Für Unternehmen, die mit der Kollision wachsender Daten, steigender Parallelität und der Verschärfung der Hardwareökonomie konfrontiert sind, ist dieser Unterschied im Ansatz nicht mehr akademisch. Es ist der Unterschied zwischen einer Plattform, die mit dem Unternehmen skaliert, und einer Plattform, die mit dem Beschaffungsbudget skaliert.
Bereit, den Unterschied zu sehen?
Wenn Sie Qlik Sense bewerten oder bereits ausführen und den in diesem Beitrag beschriebenen Speicherdruck spüren, würden wir Ihnen gerne zeigen, wie die hybride Architektur von TURBOARD die gleichen Workloads übernimmt.
Buchen Sie einen Walkthrough mit unserem Team und sehen Sie die Plattform in Aktion mit Ihren eigenen Daten. Kein Druck – wir möchten, dass Sie für Ihre spezifischen Bedürfnisse die richtige Wahl finden.
Sie können auch unsere Vollständiger BI-Vergleich Seite, um zu sehen, wie wir uns über noch mehr Unternehmensszenarien stapeln.
Blogs




Bringen Sie eine echte Geschäftsfrage mit. Sehen Sie, wie TURBOARD sie beantwortet.
Wir demonstrieren JAS auf Ihren Berichten, Ihren Definitionen und Ihrem Sicherheitskontext — nicht auf einer generischen Beispieldatenbank.