Wat gebeurt er met het in-memory model van Qlik Sense wanneer RAM niet meer goedkoop of eindeloos beschikbaar is? We vergelijken het met de hybride architectuur van TURBOARD met behulp van Qlik’s eigen documentatie en ons verleende patent op intelligente caching.
Gedurende het grootste deel van het laatste decennium waren business intelligence-platforms gebouwd op een comfortabele veronderstelling: het geheugen zou goedkoper, dichter en gemakkelijker te gooien worden voor problemen. Die veronderstelling breekt stilletjes. AI-infrastructuurbuildouts absorberen een ongekend deel van de wereldwijde DRAM- en HBM-voorziening, en grote geheugenfabrikanten hebben gewaarschuwd dat de beperkingen zich waarschijnlijk tot 2026 zullen verdiepen. Voor enterprise BI-teams is het praktische effect eenvoudig - het RAM-geheugen waar uw analyseplatform van afhankelijk is, wordt duurder, betwister en moeilijker te schalen op aanvraag.
Dit verandert de vraag die ertoe doet.
De traditionele BI-prestatievraag was: Hoe snel is het dashboard wanneer de dataset in het geheugen past? Het is de vraag waar verkopers van houden, omdat het antwoord bijna altijd “zeer snel” is. Maar het is niet langer de vraag of een platform standhoudt in de productie. De echte vraag is nu: hoe gedraagt het platform zich wanneer gegevensvolumes groeien, gelijktijdige gebruikers zich vermenigvuldigen en geheugen de bron is waar u niet gewoon meer van kunt kopen?
Die vraag heeft vandaag twee heel verschillende antwoorden op de markt. Qlik Sense vertegenwoordigt de volwassen in-memory school - laad alles in RAM, houd het daar en laat een associatieve motor snelheid leveren door nabijheid. TURBOARD vertegenwoordigt een hybride school - behandel het geheugen als een versnellingslaag voor de workloads die het meest profiteren en routeer al het andere naar kolomvormige opslag of live bronnen die voor de klus zijn ontworpen.
Beide filosofieën werken. De interessante vraag is welke beter ouder wordt naarmate de omstandigheden eromheen veranderen. Dit bericht loopt door wat er daadwerkelijk met elke architectuur gebeurt als gegevens groeien, gebruikers toenemen en RAM strak wordt - met behulp van Qlik's eigen documentatie en de gepubliceerde architectuur van TURBOARD als bewijs.
Twee architecturen, kort
Qlik Sense is gebouwd rond de QIX associatieve motor. Wanneer een toepassing wordt geladen, wordt de niet-geaggregeerde dataset in RAM bewaard, samen met de associatieve structuren die elke waarde koppelen aan elke andere waarde. Gebruikersselecties worden beantwoord door die structuren in het geheugen te doorkruisen en de berekeningsresultaten worden in de cache opgeslagen in RAM, zodat de volgende identieke verzoeken onmiddellijk terugkeren.
Qlik's eigen QVD-formaat versnelt de laadlaag drastisch - Qlik-documentatierapporten QVD leest als tien tot honderd keer sneller dan leest van andere bronnen - maar het runtime-model vereist nog steeds dat de werkende dataset in het fysieke geheugen leeft.
TURBOARD neemt een andere weg. Gegevens kunnen worden geopend via geoptimaliseerde live-verbindingen met behulp van native databasestuurprogramma's of worden geïmporteerd in een high-performance columnar-winkel zoals MariaDB ColumnStore, ClickHouse of Vertica. Veelgebruikte queryresultaten worden in de cache opgeslagen in Redis, de in-memory gegevensstructuuropslag.
Een cache-trigger-mechanisme beslist wanneer de resultaten in de cache nog steeds geldig zijn en wanneer de bron opnieuw moet worden gevraagd. Geheugen wordt opzettelijk gebruikt, voor de workloads waar het de meeste versnelling produceert - niet als het standaardhuis voor alle analytische gegevens.
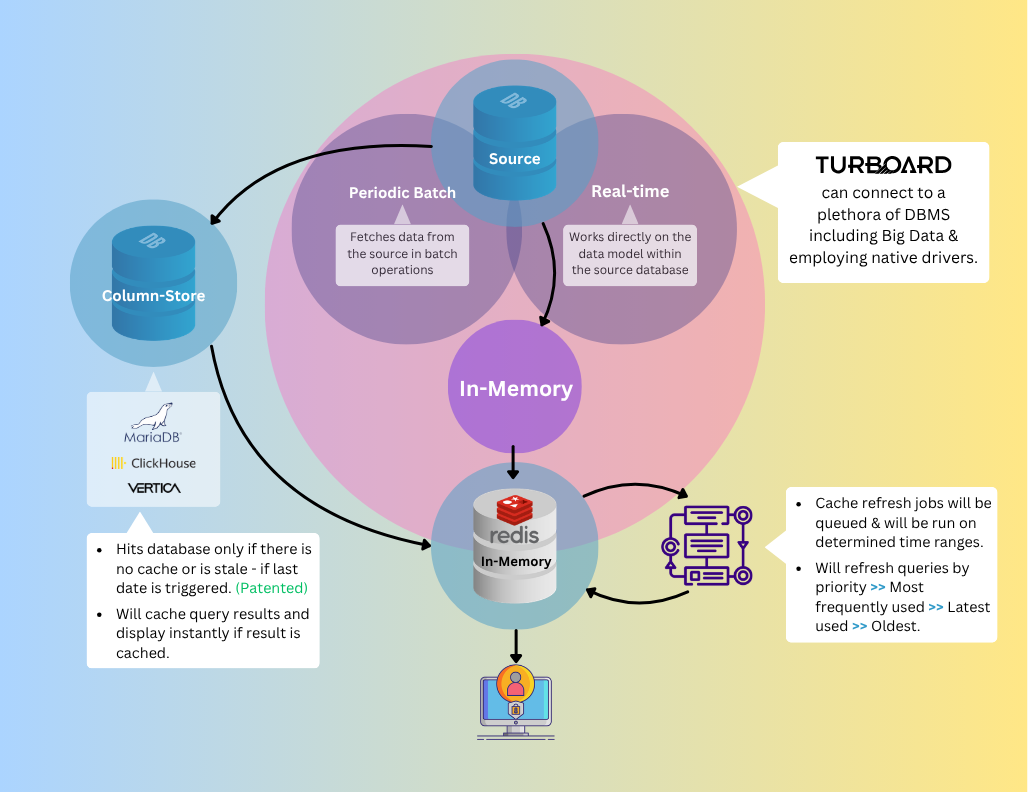
Het bovenstaande diagram laat zien hoe de lagen van TURBOARD bij elkaar passen. De rest van de post onderzoekt wat elke architectuur doet als de omstandigheden eromheen moeilijker worden.
Het eerlijke scenario: wanneer in-memory wint
Het is de moeite waard om duidelijk te zeggen: wanneer de dataset comfortabel in RAM past, wanneer concurrency bescheiden is, en wanneer de omgeving voor de toepassing is groot, is Qlik Sense echt snel. De associatieve motor is een volwassen stuk techniek, en de gebruikerservaring van het doorklikken van filters en het bekijken van aggregaties herberekenen in milliseconden is, op zijn dag, uitstekend. Voor afdelingsimplementaties, gerichte analytische toepassingen en workloads waarbij het datamodel stabiel en goed begrepen is, is de in-memory aanpak een echte kracht.
Dit is het scenario waar de meeste productdemonstraties rond zijn gebouwd. Het is ook het scenario dat u het minst vertelt over hoe een platform zich een jaar in productie zal gedragen, nadat de gegevens zijn gegroeid, het gebruikersbestand is uitgebreid en nog drie applicaties op dezelfde server zijn geïmplementeerd.
Het schaalscenario: waar de architecturen uiteenlopen
Qlik’s eigen ondersteuningsdocumentatie beschrijft het geheugenmodel in detail. De motor werkt tegen twee configureerbare drempels die bekend staan als Werken Set Laag en Werkend Set Hoog, met standaardwaarden van 70% en 90% van het fysieke RAM-geheugen respectievelijk. Onder de lage drempel behoudt de motor de in de cache opgeslagen berekeningsresultaten agressief, op basis van het principe dat ongebruikt geheugen verspild geheugen is. Zodra de lage drempel is overschreden, begint de motor met het uitzetten van in de cache opgeslagen resultaten om ruimte te maken voor nieuwe, waarbij prioriteit wordt gegeven aan uitzetting op leeftijd, grootte en oorspronkelijke berekeningstijd. Zodra de hoge drempel is overschreden, stopt het cachen effectief en kan het paginabestand van het besturingssysteem worden ingeschakeld om de motor in leven te houden. De documentatie van Qlik merkt op dat het gebruik van paginabestanden de prestaties aanzienlijk kan degraderen.
De mechanica van wat er tussen die drempels gebeurt, zijn belangrijker dan de drempels zelf. Elk in de cache opgeslagen resultaat dat wordt uitgezet, is een berekening die opnieuw moet worden berekend de volgende keer dat een gebruiker daarom vraagt. Naarmate de uitzetting versnelt, verschuift de computationele belasting van geheugen naar CPU. In een omgeving met hoge valuta, waar veel gebruikers tegelijkertijd berekeningen activeren die geen cache-antwoorden meer hebben, wordt de CPU het nieuwe knelpunt - en in tegenstelling tot geheugendruk manifesteert CPU-druk zich direct als gebruikerszichtbare latentie: dashboards die hangen, filters die seconden nodig hebben om toe te passen, sessies die time-out.
De hybride aanpak van TURBOARD verdeelt de belasting anders. De niet-geaggregeerde dataset hoeft geen RAM te bezetten, omdat de columnaire winkel is ontworpen om analytische query's efficiënt vanaf schijf te beantwoorden — alleen de kolommen lezen die een query aanraakt, zware compressie uitbuiten en aggregaties serveren met snelheden die tien jaar geleden in het geheugen zouden zijn verwerkt. Incrementeel laden houdt de kolomopslag vers zonder herhaalde volledige herladingen te forceren, wat betekent dat gebruikers bijna-live gegevens ervaren zonder de geheugenkosten van het vasthouden van de volledige dataset in RAM. De Redis-cache versnelt vervolgens de query's die het meest profiteren van versnelling - wat, in elke echte bedrijfsimplementatie, een kleine subset van het totale queryvolume is. In het volgende gedeelte wordt uitgelegd waarom.
Live data: het Direct Discovery probleem
Qlik's antwoord op workloads die het beschikbare geheugen overschrijden, is Direct Discovery, een modus waarin dimensievelden in het geheugen worden geladen terwijl meetvelden in de brondatabase blijven en op verzoek worden opgevraagd. De ontwerpintentie is redelijk; de gedocumenteerde beperkingen zijn aanzienlijk.
Gedocumenteerde beperkingen van Direct Discovery (per Qlik’s eigen hulpmaterialen):
- Enkele gedeelde databaseverbinding voor alle gebruikers van een toepassing — kan de brondatabase onder hoge gelijktijdigheid overspoelen.
- Gegenereerde SQL is niet geoptimaliseerd; voegt zich tussen in-geheugen tabellen en Direct Discovery tabellen kan zeer grote IN-clausules die de database query buffers te belasten produceren.
- Verschillende kernanalytische mogelijkheden worden niet ondersteund, inclusief Set Analyse, Insight Advisor en Dynamic Views.
- Verdere ontwikkeling is niet gepland om deze beperkingen aan te pakken, volgens Qlik’s eigen verklaring.
Voor TURBOARD is live connectiviteit geen oplossing voor geheugendruk. Het is een eersteklas onderdeel van de architectuur. Native database stuurprogramma's - in plaats van generieke ODBC-verbindingen - bieden directe, high-performance toegang tot bronsystemen, waaronder big data-platforms zoals Apache Kudu. Het cache-trigger-mechanisme voorkomt dat de brondatabase op elke gebruikersklik wordt geraakt: TURBOARD kijkt naar een aangewezen triggerveld (zoals een laatst bijgewerkte tijdstempel) en dient in de cache opgeslagen resultaten van Redis wanneer de onderliggende gegevens niet zijn gewijzigd, waarbij de bron alleen wordt opgevraagd wanneer de trigger aangeeft dat er nieuwe gegevens beschikbaar zijn. Geavanceerde analytische functies blijven volledig beschikbaar, of een widget nu uit de cache, van de kolomwinkel of uit een live bron wordt gelezen. Een enkel dashboard kan alle drie zonder compromissen mengen.
Het Pareto-inzicht en het patent dat het beschermt
In elke enterprise BI-implementatie volgt het gebruikersgedrag een voorspelbaar patroon. Ongeveer 80% van de gebruikers keert herhaaldelijk terug naar dezelfde kerndashboards — samenvattingen van de uitvoerende macht, maandelijkse prestatierapporten, regionale rollups. De overige 20% zijn power-gebruikers die ad-hoc query's uitvoeren die mogelijk nooit meer in dezelfde vorm worden uitgevoerd. De implicatie voor geheugenbeheer is direct: niet alle in de cache opgeslagen resultaten zijn even waardevol en een systeem dat ze als gelijkwaardig behandelt, verspilt zijn duurste bron.
Het uitzettingsmodel van Qlik is gedragsblind. Gevangen resultaten worden verwijderd op basis van leeftijd, grootte en oorspronkelijke berekeningstijd - niet op basis van hoe vaak daadwerkelijke gebruikers ze daadwerkelijk aanvragen. Wanneer het geheugen vult, kan de engine het dashboard niet onderscheiden dat het hele uitvoerende team elke ochtend controleert van een eenmalige query die onlangs in de cache is opgeslagen.
TURBOARD neemt de tegenovergestelde benadering. Telkens wanneer een rapport wordt bekeken, wordt de populariteitsscore verhoogd in een Redis Sorted Set - een gegevensstructuur die is ontworpen voor precies dit soort gerangschikte toegangspatroon. Het systeem onderhoudt een continu leaderboard waarvan rapporten daadwerkelijk worden gebruikt, en gebruikt dat leaderboard om te beslissen wat er in de cache blijft wanneer het geheugen strak is. De meest gevraagde rapporten zijn beschermd in Redis, waar ze met nul latentie terugkeren naar de meerderheid van de gebruikers die ervan afhankelijk zijn. Power-user query's die de cache missen, worden naar de kolomopslag of de live-bron geleid - beide zijn ontworpen om die query's snel te beantwoorden zonder inhoud met een hoge waarde te verdringen.
Kunstmatige intelligentie-aangedreven Rapid Search Result Display System met aanpassing aan de gewoonten van de gebruiker
Dit mechanisme is het voorwerp van een verleend octrooi. Het systeem werd ingediend door E-Kalite (het moederbedrijf van TURMOARD) in 2022 en verleend in 2025. Het patent heeft betrekking op de methode om gegevensweergave op de gebruikersinterface te versnellen, de invoer-/uitvoerlaadtijden te verkorten en de frequentie van toegang tot gegevensopslag- en gegevensoverdrachtshardware te verminderen - met andere woorden, de combinatie van op gebruik gebaseerde score, intelligente cachevernieuwing en triggergebaseerde stalens-detectie waarmee TURBOARD enterprise-workloads kan bedienen op geheugenbudgetten die puur in-memory-architecturen in pagefile-gebied zouden duwen.
Het strategische punt is eenvoudig: wanneer het geheugen overvloedig is, kost gedragsblinde caching u efficiëntie. Wanneer geheugen schaars is, kost het je prestaties.
Naast elkaar
| Vraag | Qlik Zintuigbenadering | TURBOARD Aanpak |
|---|---|---|
| Waar wonen de data bij runtime? | In RAM, volledig | In columnaire winkel of live bron; resultaten selectief in de cache in Redis |
| Wat gebeurt er als het geheugen vult? | Cache uitzetting op leeftijd/grootte, vervolgens pagefile | Gedragsmatig gescoorde retentie; overloop geserveerd vanuit kolom of live bron |
| Hoe wordt herhaald gebruik afgehandeld? | In-geheugen resultaat cache, blindelings uitgezet | Redis cache, behouden door gebruiksscore (gepatenteerd) |
| Hoe wordt data freshness behouden? | Volledige of QVD-incrementele herlaadbeurten in RAM | Incrementele kolomladingen + cache triggers |
| Hoe worden live queries afgehandeld? | Direct Discovery, met gedocumenteerde limieten | Native drivers, volledige analyses behouden |
| Schaalfilosofie | Meer geheugen bieden | Gebruik het geheugen selectief, routeer de rest |
Conclusie
Qlik Sense blijft een capabel in-memory analytics platform, en in de omstandigheden waarvoor het is ontworpen - begrensde datasets, voorspelbare gelijktijdigheid, royale geheugenvoorziening - presteert het goed. De vraag die dit bericht heeft geprobeerd te beantwoorden, is wat er gebeurt, omdat die voorwaarden moeilijker worden om aan te voldoen. De datavolumes krimpen niet. Concurrentieverwachtingen zijn niet ontspannend. En de kosten en beschikbaarheid van het geheugen, voor het eerst in lange tijd, bewegen in de verkeerde richting.
De architectuur van TURBOARD is een weddenschap dat het komende decennium van BI-prestaties zal worden gewonnen door platforms die gebruik geheugen intelligent in plaats van overvloedig. Hybride gegevenstoegang, kolomopslag, native live-connectiviteit en een gepatenteerde door gebruik gescoorde cache laten TURBOARD prestaties op ondernemingsschaal leveren op geheugenbudgetten die puur in-memory architecturen moeite hebben om binnen te leven.
Voor organisaties die worden geconfronteerd met de botsing van groeiende gegevens, stijgende gelijktijdigheid en het aanscherpen van de hardware-economie, is dat verschil in aanpak niet langer academisch. Het is het verschil tussen een platform dat schaalt met het bedrijf en een platform dat schaalt met het inkoopbudget.
Klaar om het verschil te zien?
Als je Qlik Sense evalueert - of het al uitvoert en de geheugendruk begint te voelen die in dit bericht wordt beschreven - laten we je graag zien hoe de hybride architectuur van TURBOARD dezelfde workloads aanpakt.
Boek een walkthrough met ons team en zie het platform in actie met je eigen data. Geen druk - we hebben liever dat u de juiste pasvorm vindt voor uw specifieke behoeften.
U kunt ook onze verkennen Volledige BI-vergelijking pagina om te zien hoe we opstapelen over nog meer enterprise scenario’s.
Blogs




Breng één echte bedrijfsvraag mee. Zie hoe TURBOARD die beantwoordt.
We demonstreren JAS op uw rapporten, uw definities en uw beveiligingscontext — niet op een generieke voorbeelddatabase.