当内存不再便宜或无法无限使用时,Qlik Sense 的内存模型会发生什么变化? 我们将其与TURBOARD的混合架构进行比较,该架构采用Qlik自有文档,并授予了智能缓存专利。
过去十年的大部分时间里,商业智能平台都建立在一个舒适的假设之上:记忆会不断变得更便宜、更密集,更容易被问题所困扰。 这种假设正在悄然打破。 人工智能基础设施建设正在吸收全球DRAM和HBM供应的空前份额,主要内存制造商警告称,到2026年,限制措施可能会进一步加剧。 对于企业商业智能(BI)团队而言,实际效果很简单——您所依赖的数据分析平台所依赖的内存正变得越来越昂贵、更具争议性,且更难以按需扩展。
这改变了一个重要问题。
传统的商业智能性能问题是: 当数据集与内存相适应时,仪表盘的速度有多快? 问题是供应商喜欢的问题,因为答案几乎总是“很快”。 但决定一个平台能否在生产中占据优势的问题已不再是问题。 现在真正的问题是: 当数据量增长、并发用户倍增以及内存是您无法简单地购买更多资源时,平台会如何表现?
这个问题在当今市场上有两种截然不同的答案。 Qlik Sense 代表着成熟的记忆中学校——将所有内容加载到 RAM 中,保持其中,并让一个联想引擎通过近距离传递速度。 TURBOARD 代表一个混合型学校——将内存视为对工作最有利的工作负载的加速层,并将其他所有内容路由到为该作业设计的柱状存储或实时源。
两种哲学都有效。 有趣的是,随着周围条件的变化,哪个年龄会更好。 本文介绍了随着数据增长、用户数量增加以及内存紧张,每个架构实际发生的情况,以Qlik自己的文档和TURBOARD发布的架构为参考。
两种架构,简要
Qlik Sense 是围绕 QIX 联想引擎打造的。 当应用程序加载时,未聚合的数据集与关联结构一起以内存形式保存,这些关联结构将每个值与所有其他值关联。 用户选择通过跨越这些内存结构来获取答案,计算结果会缓存在内存中,以便后续相同的请求立即返回。
Qlik 自身的 QVD 格式极大地加速了加载层——Qlik 文档报告的 QVD 读取速度比其他源读取速度快了 10 到 100 倍,但运行时模型仍要求工作数据集能够实现物理内存。
TURBOARD走着一条不同的道路。 可以通过使用原生数据库驱动程序进行优化的实时连接,或导入到 MariaDB ColumnStore、ClickHouse 或 Vertica 等高性能的柱子存储中,访问数据。 常用的查询结果在内存数据结构存储的 Redis 中被缓存。
缓存触发机制决定缓存结果何时仍然有效,以及何时需要重新查询源。 内存是刻意使用的,用于产生最高加速度的工作负载,而非作为所有分析数据的默认主场。
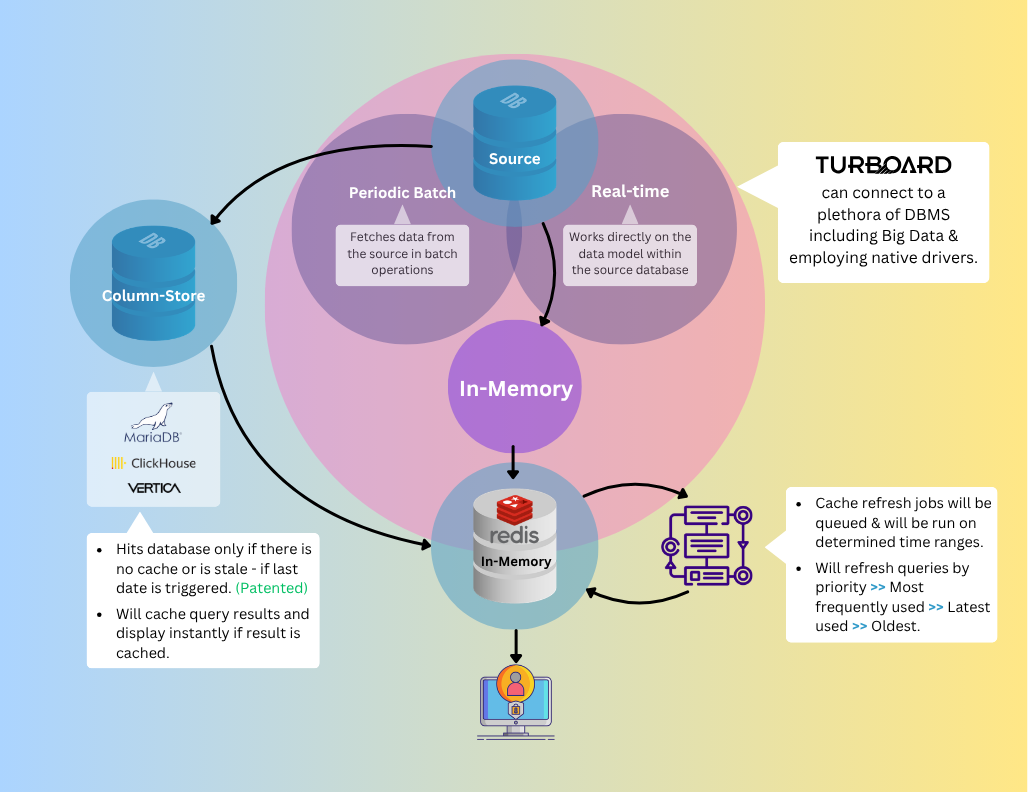
上图显示了TURBOARD的层如何相合成。 文章的其余部分探讨了每种架构在周围条件越来越难时所做的事情。
公平情况:当记忆中获胜时
值得明确地说: 当数据集在内存中舒适地适应,当并发性为小时,当应用环境大小时,Qlik Sense 会真正快速。 联想引擎是一门成熟的工程,而通过滤波器进行点击并以毫秒为单位重新计算的用户体验,在当天就非常出色。 对于部门部署、专注分析应用以及数据模型稳定且易于理解的工作负载而言,内存方法是实实在在的优势。
这是大多数产品演示都围绕此构建的场景。 也是一种最不向上的情景,说明一个平台在生产一年后会如何表现,数据不断增长,用户群不断扩大,同时又有三个应用程序被部署到同一台服务器上。
缩放场景:架构存在差异
Qlik 自己的支持文档详细描述了内存模型。 发动机针对两个可配置的阈值运行,称为 工作集低置和工作集高,默认值为70%,物理内存为90% 分别。 低于低阈值,该引擎会积极保留缓存计算结果,其原理是未使用的内存会浪费内存。 突破低门槛后,发动机开始剔除缓存结果,为新结果腾出空间,优先根据年龄、尺寸和原始计算时间进行驱逐。 跨越高门槛后,缓存会有效停止,操作系统的页面文件可能会被占用以保持引擎的正常运行。 Qlik 的文档指出,使用页面文件可能会显著降低性能。
这些阈值之间所发生机制比阈值本身更重要。 每个被驱逐的缓存结果都是一次计算,下次用户请求时需要重新计算。 随着驱逐加速,计算负载从内存转移到了CPU。 在高并发环境中,许多用户同时触发不再具有缓存答案的计算,CPU成为新的瓶颈——与内存压力不同,CPU压力直接表现为用户可见的延迟:挂起的仪表板、需要几秒钟的过滤器、需要时间的会话。
TURBOARD 的混合方式对负载的分配方式不同。 未聚合的数据集无需占用内存,因为 立柱存储旨在高效回答来自磁盘的分析性查询 — 仅读取查询所涉及的列,利用重压缩,并以十年前需要内存处理的速度提供聚合。 增量加载可保持柱状存储的新鲜,且无需强制重复重载,这意味着用户无需存储完整数据卡(RAM)即可获得近乎实时的数据。 然后,Redis 缓存会加速那些从加速中获益最多的查询——在任何实际企业部署中,加速度都是总查询量的一小部分。 下一节解释了原因。
实时数据:直接发现问题
Qlik 对超出可用内存的工作负载的回答是直接发现,即将维度字段加载到内存中,而测量字段则保留在源数据库中,并按需查询。 设计意图合理;有记录的局限性十分显著。
Direct Discovery(根据Qlik自身的帮助材料)的记录限制:
- 单共享数据库连接 对于所有应用程序用户——可以以高并发性充斥源数据库。
- 生成的 SQL 未进行优化; 内存表中表与直接发现表之间的连接可以产生非常大的“输入”子句,从而拉紧数据库查询缓冲区。
- 多个核心分析功能不受支持。 包括数据集分析、洞察顾问和动态视图。
- 未计划进一步开发 根据Qlik自己的陈述,应对这些限制。
对TURBARD而言,实时连接并不是记忆压力的解决方法。 它是建筑中的一流部分。 原生数据库驱动程序(而非通用的ODBC连接)可直接且高性能地访问源系统,包括 Apache Kudu 等大数据平台。 缓存触发机制可防止每个用户点击时都击中源数据库:TURBOARD 会监视指定的触发字段(例如最后更新的时间戳),并在底层数据未更改时为 Redis 提供缓存结果,仅在触发器显示新数据可用时查询源。 无论一个小部件是从缓存、柱子存储库还是从实时源读取,高级分析功能仍然完全可用。 单个仪表板可以随意混合所有三个。
帕雷托洞视与保护其专利
在任何企业商业智能部署中,用户行为都遵循可预测的模式。 大约80%的用户会反复返回同一个核心仪表板 — 执行摘要、月度绩效报告、区域汇总。 其余20%是运行临时查询的供电用户,这些查询可能再也不会以相同形式运行。 内存管理的含义是直接的:并非所有缓存结果都同样有价值,而一个将它们视为等效的系统,却浪费了其最昂贵的资源。
Qlik的驱逐模式是行为盲的。 缓存结果会根据年龄、大小和原始计算时间进行删除,而不是根据实际用户实际要求的频率。 当内存充满时,引擎无法将整个管理团队每天早上检查的仪表盘与最近恰好缓存的一次查询区分开来。
TURBOARD采取相反的做法。 每次查看报告时,其受欢迎程度都会在Redis排序集中递增——该数据集正是为这种排名访问模式而设计的。 系统会持续维护当前实际使用哪些报表的排行榜,并使用该管理板来确定内存紧张时缓存中哪些内容。 最需要的报告在Redis中受到保护,这些报告向大多数依赖这些报告的用户以零延迟返回。 漏掉缓存的功耗器查询会路由到列式存储库或实时源,这两种查询都经过精心设计,能够快速回答这些查询,而不会取代高值缓存内容。
基于人工智能的快速搜索结果显示系统,可适应用户习惯
该机制属于授予专利的主体。 该系统由E-Kalite(TURBARD的母公司)于2022年提交,并于2025年获批。 该专利涵盖加速用户界面数据显示、缩短输入/输出加载时间以及减少对数据存储和数据传输硬件访问频率的方法——即基于使用的评分、智能缓存刷新和触发式陈旧检测相结合的方式,使TURBOARD能够在内存预算下为企业工作负载提供服务,从而将纯粹的内存架构推向页面文件领域。
战略要点很简单: 当内存充足时,行为盲缓存会降低效率。 当内存稀缺时,会耗费你的性能。
并排
| 问题 | Qlik Sense 方法 | TURBOARD方法 |
|---|---|---|
| 数据在运行时的位置在哪里? | 在RAM中,完整 | 在 loprar 商店或实时源中;结果在 Redis 中选择性缓存 |
| 当记忆充满时会发生什么? | 按年龄/大小划分的缓存驱逐,然后按页面文件 | 行为评分保留;从柱状或实时源处溢出 |
| 重复使用是如何处理的? | 内存结果缓存,盲目驱逐 | 由使用评分保留的 Redis 缓存(专利) |
| 数据清新如何维持? | 全载或QVD生成式重新加载到RAM中 | 增量列加载 + 缓存触发器 |
| 实时查询是如何处理的? | 直接发现,包含有记录的限值 | 保留原生驱动程序和完整分析 |
| 缩放哲学 | 增加内存 | 选择性地使用内存,将其余部分进行路由 |
结论
Qlik Sense 仍然是一个功能强大的内存分析平台,在设计时(包括有边界数据集、可预测的并发、出色的内存配置),它表现良好。 本文试图回答的问题是,随着这些条件越来越难以满足,会发生什么。 数据量不会缩小。 并发预期并不令人放松。 内存的成本和可用性,这是长期以来首次,正朝着错误的方向发展。
TURBOARD 的架构值得一试,未来十年的商业智能表现将由平台所赢得 智能地使用内存,而不是大量使用。 混合数据访问、柱状存储、原生实时连接以及专利使用评分缓存,使TURBOARD能够在内存预算上实现企业级性能,而这些存储架构在内存中难以实现。
对于面临数据不断增长、并发性上升以及硬件经济趋同的组织而言,这种方法的差异已不再具有学术性。 这是一个与企业进行扩展的平台与与采购预算相叠加的平台之间的区别。
准备好看到区别了吗?
如果你正在评估 Qlik Sense——或者已经运行它,并开始感受到本文所描述的内存压力——我们很乐意向您展示 TURBOARDD 的混合架构如何处理相同的工作负载。
与我们的团队一起预约演练,并使用您自己的数据查看平台的实际运行情况。 无需施加压力——我们希望您能找到适合您特定需求的合适选择。
您也可以探索我们的 完整商业信息对比 页面,查看我们如何在更多企业场景中叠加。




带来一个真实的业务问题,看看 TURBOARD 如何回答。
我们在您的报表、您的定义和您的安全上下文中演示 JAS —— 而不是在通用示例数据库上。