¿Qué sucede con el modelo en memoria de Qlik Sense cuando la RAM ya no es barata o está disponible sin fin? Lo comparamos con la arquitectura híbrida de TURBOARD utilizando la propia documentación de Qlik y nuestra patente concedida sobre almacenamiento en caché inteligente.
Durante la mayor parte de la última década, las plataformas de inteligencia empresarial se construyeron sobre una suposición cómoda: la memoria seguiría siendo más barata, más densa y más fácil de lanzar a los problemas. Esa suposición se está rompiendo silenciosamente. Las construcciones de infraestructura de IA están absorbiendo una parte sin precedentes del suministro global de DRAM y HBM, y los principales fabricantes de memoria han advertido que es probable que las restricciones se profundicen hasta 2026. Para los equipos de BI empresarial, el efecto práctico es simple: la RAM de la que depende su plataforma de análisis se está volviendo más cara, más disputada y más difícil de escalar a pedido.
Esto cambia la pregunta que importa.
La pregunta tradicional de rendimiento de BI fue: ¿Qué tan rápido es el panel cuando el conjunto de datos encaja en la memoria? Es la pregunta que los vendedores aman, porque la respuesta es casi siempre “muy rápida”. Pero ya no es la pregunta que decide si una plataforma se mantendrá en producción. La verdadera pregunta ahora es: ¿Cómo se comporta la plataforma cuando los volúmenes de datos crecen, los usuarios concurrentes se multiplican y la memoria es el recurso que no se puede simplemente comprar más?
Esa pregunta tiene dos respuestas muy diferentes en el mercado hoy en día. Qlik Sense representa la escuela madura en memoria: cargue todo en la memoria RAM, manténgalo allí y deje que un motor asociativo entregue velocidad a través de la proximidad. TURBOARD representa una escuela híbrida: trata la memoria como una capa de aceleración para las cargas de trabajo que más se benefician y enruta todo lo demás al almacenamiento en columna o a fuentes en vivo diseñadas para el trabajo.
Ambas filosofías funcionan. La pregunta interesante es qué envejece mejor a medida que cambian las condiciones a su alrededor. Esta publicación recorre lo que realmente le sucede a cada arquitectura a medida que los datos crecen, los usuarios aumentan y la RAM se ajusta, utilizando la propia documentación de Qlik y la arquitectura publicada de TURBOARD como evidencia.
Dos arquitecturas, brevemente
Qlik Sense está construido alrededor del motor asociativo QIX. Cuando se carga una aplicación, el conjunto de datos no agregado se mantiene en la RAM, junto con las estructuras asociativas que vinculan cada valor a cualquier otro valor. Las selecciones de usuario se responden atravesando esas estructuras en memoria, y los resultados del cálculo se almacenan en caché en la RAM, por lo que las solicitudes idénticas posteriores se devuelven instantáneamente.
El propio formato QVD de Qlik acelera dramáticamente la capa de carga: la documentación de Qlik informa que QVD se lee de diez a cien veces más rápido que las lecturas de otras fuentes, pero el modelo de tiempo de ejecución aún requiere que el conjunto de datos de trabajo viva en memoria física.
TURBOARD toma un camino diferente. Se puede acceder a los datos a través de conexiones en vivo optimizadas utilizando controladores de base de datos nativos, o importados en una tienda columnar de alto rendimiento, como MariaDB ColumnStore, ClickHouse o Vertica. Los resultados de la consulta utilizados con frecuencia se almacenan en caché en Redis, el almacén de estructura de datos en memoria.
Un mecanismo de disparo de caché decide cuándo los resultados almacenados en caché siguen siendo válidos y cuándo es necesario volver a consultar la fuente. La memoria se utiliza deliberadamente, para las cargas de trabajo donde produce la mayor aceleración, no como el hogar predeterminado para todos los datos analíticos.
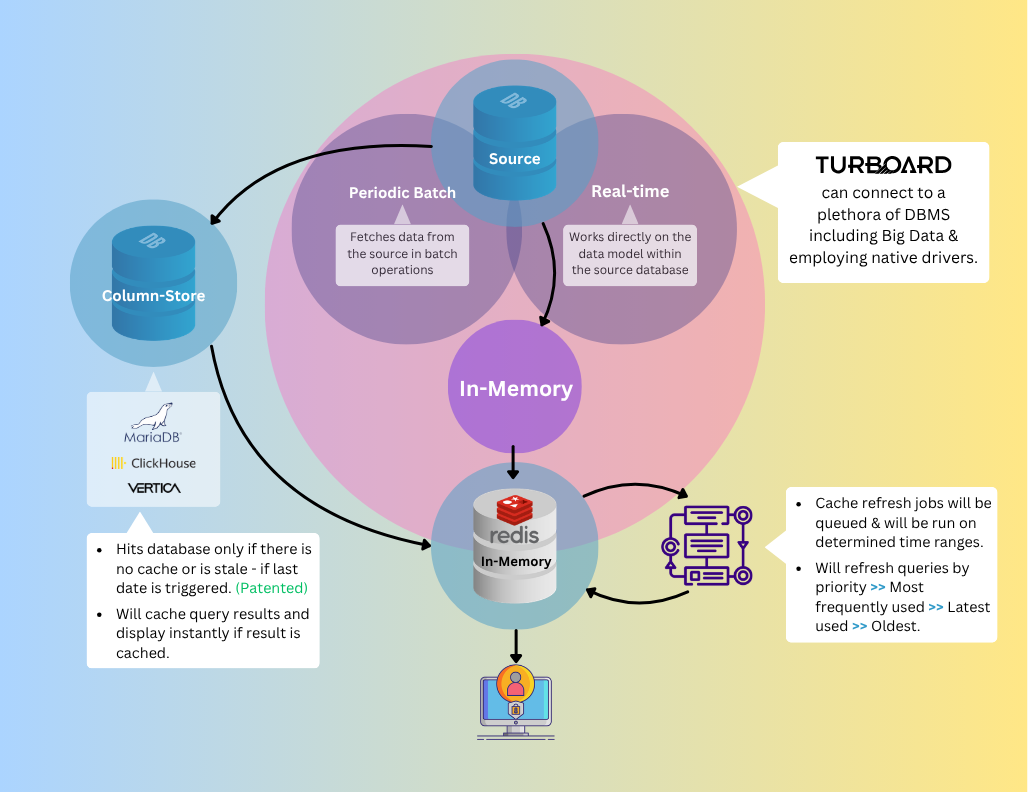
El diagrama anterior muestra cómo encajan las capas de TURBOARD. El resto de la publicación examina lo que cada arquitectura hace a medida que las condiciones a su alrededor se vuelven más difíciles.
El escenario justo: cuando gana en memoria
Vale la pena decir claramente: Cuando el conjunto de datos se ajusta cómodamente a la RAM, cuando la concurrencia es modesta, y cuando el entorno está dimensionado para la aplicación, Qlik Sense es realmente rápido. El motor asociativo es una pieza madura de ingeniería, y la experiencia del usuario de hacer clic a través de filtros y ver las agregaciones recalcular en milisegundos es, en su día, excelente. Para implementaciones departamentales, aplicaciones analíticas enfocadas y cargas de trabajo donde el modelo de datos es estable y bien entendido, el enfoque en memoria es una fuerza real.
Este es el escenario en el que se construyen la mayoría de las demostraciones de productos. También es el escenario que menos le dice sobre cómo se comportará una plataforma un año en producción, después de que los datos hayan crecido, la base de usuarios se haya expandido y se hayan implementado tres aplicaciones más en el mismo servidor.
El escenario de escalado: donde las arquitecturas divergen
La propia documentación de soporte de Qlik describe el modelo de memoria en detalle. El motor opera frente a dos umbrales configurables conocidos como Conjunto de trabajo bajo y conjunto de trabajo alto, con valores predeterminados de 70% y 90% de RAM física respectivamente. Por debajo del umbral bajo, el motor retiene los resultados de cálculo almacenados en caché agresivamente, según el principio de que la memoria no utilizada es memoria desperdiciada. Una vez que se cruza el umbral bajo, el motor comienza a desalojar los resultados almacenados en caché para dejar espacio para los nuevos, priorizando el desalojo por edad, tamaño y tiempo de cálculo original. Una vez que se cruza el umbral alto, el almacenamiento en caché se detiene efectivamente y el archivo de página del sistema operativo puede estar activado para mantener el motor vivo. La documentación de Qlik señala que el uso del archivo de página puede degradar el rendimiento significativamente.
La mecánica de lo que sucede entre esos umbrales importa más que los umbrales mismos. Cada resultado almacenado en caché que se desaloja es un cálculo que deberá volver a calcularse la próxima vez que un usuario lo solicite. A medida que el desalojo se acelera, la carga computacional cambia de la memoria a la CPU. En un entorno de alta concurrencia, donde muchos usuarios están activando simultáneamente cálculos que ya no tienen respuestas en caché, la CPU se convierte en el nuevo cuello de botella, y a diferencia de la presión de la memoria, la presión de la CPU se manifiesta directamente como latencia visible para el usuario: paneles que se cuelgan, filtros que tardan segundos en aplicarse, sesiones que se agotan.
El enfoque híbrido de TURBOARD distribuye la carga de manera diferente. El conjunto de datos no agregado no necesita ocupar la RAM, porque La tienda columnar está diseñada para responder a las consultas analíticas de manera eficiente desde el disco — leer solo las columnas que toca una consulta, explotar la compresión pesada y servir agregaciones a velocidades que habrían requerido procesamiento en memoria hace una década. La carga incremental mantiene la tienda columnar fresca sin forzar las recargas completas repetidas, lo que significa que los usuarios experimentan datos casi en vivo sin el costo de memoria de mantener el conjunto de datos completo en la RAM. La caché de Redis acelera entonces las consultas que más se benefician de la aceleración, que, en cualquier implementación empresarial real, es un pequeño subconjunto del volumen total de consultas. La siguiente sección explica por qué.
Datos en vivo: el problema del descubrimiento directo
La respuesta de Qlik a las cargas de trabajo que exceden la memoria disponible es Direct Discovery, un modo en el que los campos de dimensión se cargan en la memoria mientras que los campos de medida permanecen en la base de datos de origen y se consultan bajo demanda. La intención de diseño es razonable; las limitaciones documentadas son significativas.
Limitaciones documentadas de Descubrimiento directo (por los propios materiales de ayuda de Qlik):
- Conexión de base de datos compartida única Para todos los usuarios de una aplicación, puede inundar la base de datos de origen bajo alta concurrencia.
- SQL generado no está optimizado; Las uniones entre las tablas en memoria y las tablas de descubrimiento directo pueden producir cláusulas IN muy grandes que tensionan los búferes de consulta de la base de datos.
- Varias capacidades analíticas básicas no están soportadas, Incluye Análisis de conjuntos, Asesor de información y Vistas dinámicas.
- No se ha previsto ningún desarrollo adicional Para abordar estas limitaciones, según la propia declaración de Qlik.
Para TURBOARD, la conectividad en vivo no es una solución para la presión de la memoria. Es una parte de primera clase de la arquitectura. Los controladores de bases de datos nativos, en lugar de las conexiones ODBC genéricas, proporcionan acceso directo y de alto rendimiento a los sistemas de origen, incluidas las plataformas de big data como Apache Kudu. El mecanismo de disparo de caché evita que la base de datos de origen se acerque a cada clic del usuario: TURBOARD observa un campo de activación designado (como una última marca de tiempo actualizada) y sirve resultados almacenados en caché de Redis cuando los datos subyacentes no han cambiado, consultando la fuente solo cuando el desencadenador indica que los datos nuevos están disponibles. Las funciones analíticas avanzadas siguen estando completamente disponibles, ya sea que un widget esté leyendo desde la caché, desde la tienda columnar o desde una fuente en vivo. Un solo tablero puede mezclar los tres sin compromiso.
La visión de Pareto, y la patente que la protege
En cualquier implementación de BI empresarial, el comportamiento del usuario sigue un patrón predecible. Aproximadamente el 80% de los usuarios regresan repetidamente a los mismos paneles de control principales — resúmenes ejecutivos, informes mensuales de rendimiento, agrupaciones regionales. El 20% restante son usuarios avanzados que ejecutan consultas ad-hoc que nunca se pueden volver a ejecutar en la misma forma. La implicación para la gestión de la memoria es directa: no todos los resultados almacenados en caché son igualmente valiosos, y un sistema que los trata como equivalentes está desperdiciando su recurso más caro.
El modelo de desalojo de Qlik es ciego al comportamiento. Los resultados almacenados en caché se eliminan según la edad, el tamaño y el tiempo de cálculo original, no en función de la frecuencia con la que los usuarios reales realmente los solicitan. Cuando la memoria se llena, el motor no puede distinguir el tablero de instrumentos que todo el equipo ejecutivo comprueba cada mañana de una consulta única que pasó a ser almacenada en caché recientemente.
TURBOARD adopta el enfoque contrario. Cada vez que se ve un informe, su puntuación de popularidad se incrementa en un conjunto clasificado Redis, una estructura de datos diseñada exactamente para este tipo de patrón de acceso clasificado. El sistema mantiene una tabla de clasificación continua de la que se están utilizando realmente los informes, y utiliza esa tabla de clasificación para decidir qué permanece en la caché cuando la memoria es estrecha. Los informes más solicitados están protegidos en Redis, donde regresan con latencia cero a la mayoría de los usuarios que dependen de ellos. Las consultas de usuario de potencia que se pierden la caché se enrutan a la tienda columnar o a la fuente en vivo, ambas diseñadas para responder rápidamente a esas consultas sin desplazar el contenido almacenado en caché de alto valor.
Sistema de visualización de resultados de búsqueda rápida impulsado por inteligencia artificial con adaptación a los hábitos de usuario
Este mecanismo es objeto de una patente concedida. El sistema fue presentado por E-Kalite (la empresa matriz de TURBOARD) en 2022 y otorgado en 2025. La patente cubre el método de aceleración de la visualización de datos en la interfaz de usuario, acortando los tiempos de carga de entrada / salida y reduciendo la frecuencia de acceso al hardware de almacenamiento de datos y transmisión de datos; en otras palabras, la combinación de puntuación basada en el uso, actualización de caché inteligente y detección de obsoleto basada en disparadores que permite a TURBOARD servir cargas de trabajo empresariales en presupuestos de memoria que empujarían arquitecturas puramente en memoria al territorio de archivo de página.
El punto estratégico es sencillo: Cuando la memoria es abundante, el almacenamiento en caché ciego al comportamiento le cuesta eficiencia. Cuando la memoria es escasa, te cuesta rendimiento.
Lado a lado
| ¿La pregunta | Enfoque de sentido Qlik | Enfoque de TURBOARD |
|---|---|---|
| ¿Dónde viven los datos en tiempo de ejecución? | En RAM, en su totalidad | En la tienda columnar o fuente en vivo; los resultados se almacenan en caché selectivamente en Redis |
| ¿Qué sucede cuando la memoria se llena? | Desalojo en caché por edad/tamaño, luego archivo de página | Retención marcada por el comportamiento; desbordamiento servido desde columna o fuente en vivo |
| ¿Cómo se maneja el uso repetido? | Alcance de resultados en memoria, desalojado a ciegas | Redis caché, retenido por la puntuación de uso (patentado) |
| ¿Cómo se mantiene la frescura de los datos? | Recargas completas o incrementales QVD en RAM | Cargas columnares incrementales + disparadores de caché |
| ¿Cómo se manejan las consultas en vivo? | Descubrimiento directo, con límites documentados | Controladores nativos, se conservan análisis completos |
| Fisofía de escalado | Provisión de más memoria | Utilice la memoria de forma selectiva, enrute el resto |
Conclusión
Qlik Sense sigue siendo una plataforma de análisis en memoria capaz, y en las condiciones para las que fue diseñado, conjuntos de datos limitados, concurrencia predecible y aprovisionamiento de memoria generoso, funciona bien. La pregunta que esta publicación ha tratado de responder es qué sucede a medida que esas condiciones se vuelven más difíciles de cumplir. Los volúmenes de datos no se están reduciendo. Las expectativas de concurrencia no son relajantes. Y el costo y la disponibilidad de la memoria, por primera vez en mucho tiempo, se están moviendo en la dirección equivocada.
La arquitectura de TURBOARD es una apuesta a que la próxima década de rendimiento de BI se ganará por plataformas que Utiliza la memoria de manera inteligente en lugar de abundante. El acceso a datos híbridos, el almacenamiento en columna, la conectividad en vivo nativa y una caché patentada con puntaje de uso permiten a TURBOARD ofrecer un rendimiento a escala empresarial en presupuestos de memoria que las arquitecturas puramente en memoria luchan por vivir dentro.
Para las organizaciones que se enfrentan a la colisión de datos crecientes, el aumento de la concurrencia y el endurecimiento de la economía del hardware, esa diferencia de enfoque ya no es académica. Es la diferencia entre una plataforma que escala con el negocio y una plataforma que escala con el presupuesto de adquisiciones.
¿Preparado para ver la diferencia?
Si está evaluando Qlik Sense, o ya lo ejecuta y comienza a sentir la presión de memoria descrita en esta publicación, nos encantaría mostrarle cómo la arquitectura híbrida de TURBOARD maneja las mismas cargas de trabajo.
Reserve un recorrido con nuestro equipo y vea la plataforma en acción con sus propios datos. Sin presión, preferimos que encuentre el ajuste adecuado para sus necesidades específicas.
También puede explorar nuestro Comparación completa de BI Página para ver cómo nos acumulamos en aún más escenarios empresariales.
Blogs




Traiga una pregunta de negocio real. Vea cómo la responde TURBOARD.
Demostramos JAS sobre sus informes, sus definiciones y su contexto de seguridad — no sobre una base de datos de ejemplo genérica.