Co dzieje się z modelem Qlik Sense w pamięci, gdy pamięć RAM nie jest już tania lub nieskończenie dostępna? Porównujemy go do architektury hybrydowej TURBOARD za pomocą własnej dokumentacji Qlik i naszego przyznanego patentu na inteligentne buforowanie.
Przez większość ostatniej dekady platformy business intelligence były zbudowane na wygodnym założeniu: pamięć byłaby coraz tańsza, gęstsza i łatwiejsza do rzucenia na problemy. To założenie jest po cichu łamane. Budowy infrastruktury AI pochłaniają bezprecedensowy udział globalnych dostaw pamięci DRAM i HBM, a główni producenci pamięci ostrzegają, że ograniczenia prawdopodobnie pogłębią się do 2026 roku. W przypadku zespołów BI przedsiębiorstwa praktyczny efekt jest prosty - RAM, od której zależy Twoja platforma analityczna, staje się coraz droższa, bardziej kwestionowana i trudniejsza do skalowania na żądanie.
To zmienia pytanie, które ma znaczenie.
Tradycyjne pytanie o wydajność BI brzmiało: Jak szybki jest pulpit nawigacyjny, gdy zbiór danych pasuje do pamięci? To pytanie, które uwielbiają sprzedawcy, ponieważ odpowiedź jest prawie zawsze „bardzo szybka”. Ale to już nie pytanie decyduje, czy platforma utrzyma się w produkcji. Prawdziwe pytanie brzmi teraz: Jak zachowuje się platforma, gdy rosną wolumeny danych, mnożą się współbieżni użytkownicy, a pamięć jest zasobem, którego nie można po prostu kupić więcej?
To pytanie ma dziś dwie bardzo różne odpowiedzi na rynku. Qlik Sense reprezentuje dojrzałą szkołę w pamięci - załaduj wszystko do pamięci RAM, zatrzymaj go tam i pozwól, aby silnik asocjacyjny zapewniał prędkość przez bliskość. TURBOARD reprezentuje szkołę hybrydową - traktuj pamięć jako warstwę przyspieszenia dla obciążeń, które przynoszą największe korzyści, i skieruj wszystko inne do pamięci kolumnowej lub źródeł na żywo zaprojektowanych do pracy.
Obie filozofie działają. Ciekawe pytanie brzmi, który z nich starzeje się lepiej, gdy zmieniają się warunki wokół niego. Ten post przechodzi przez to, co faktycznie dzieje się z każdą architekturą, gdy dane rosną, użytkownicy rosną, a pamięć RAM staje się ciasna - wykorzystując własną dokumentację Qlik i publikowaną architekturę TURBOARD jako dowodów.
Dwie architektury, krótko
Qlik Sense jest zbudowany wokół silnika asocjacyjnego QIX. Gdy aplikacja się ładuje, niezagregowany zbiór danych jest przechowywany w pamięci RAM, wraz ze strukturami asocjacyjnymi, które łączą każdą wartość z każdą inną wartością. Odbiera się od użytkowników, przemierzając te struktury w pamięci, a wyniki obliczeń są buforowane w pamięci RAM, więc kolejne identyczne żądania zwracają się natychmiast.
Własny format QVD Qlik dramatycznie przyspiesza warstwę ładowania - Qlik raporty dokumentacyjne QVD odczytuje się jako dziesięć do stu razy szybciej niż odczyty z innych źródeł - ale model środowiska wykonawczego nadal wymaga, aby zestaw danych roboczych żył w pamięci fizycznej.
TURBOARD wybiera inną drogę. Dostęp do danych można uzyskać za pomocą zoptymalizowanych połączeń na żywo za pomocą natywnych sterowników bazy danych lub zaimportować do wysokowydajnego sklepu kolumnowego, takiego jak MariaDB ColumnStore, ClickHouse lub Vertica. Często używane wyniki zapytań są buforowane w Redis, magazynie struktury danych w pamięci.
Mechanizm buforowania-wyzwalacza decyduje, kiedy buforowane wyniki są nadal prawidłowe i kiedy źródło musi zostać ponownie zapytane. Pamięć jest używana celowo, w przypadku obciążeń, w których zapewnia największe przyspieszenie - nie jako domyślny dom dla wszystkich danych analitycznych.
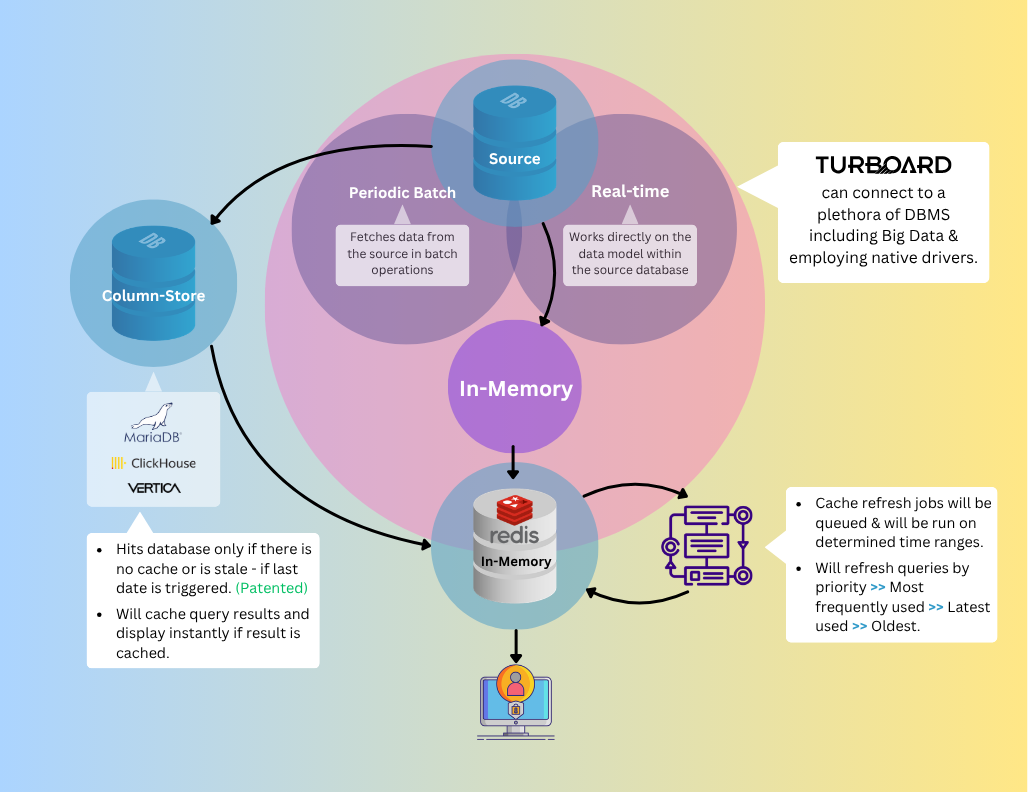
Powyższy schemat pokazuje, jak warstwy TURBOARD pasują do siebie. Reszta postu bada, co każda architektura robi, gdy warunki wokół niej stają się trudniejsze.
Scenariusz sprawiedliwy: kiedy wygrana in-memory
Warto powiedzieć wyraźnie: gdy zestaw danych pasuje wygodnie do pamięci RAM, gdy współbieżność jest skromna, a środowisko jest dostosowane do aplikacji, Qlik Sense jest naprawdę szybki. Silnik asocjacyjny jest dojrzałym elementem inżynierii, a doświadczenie użytkownika w klikaniu filtrów i obserwowaniu, jak agregacje przeliczają się w ciągu milisekund, jest w swoim dniu doskonałe. W przypadku wdrożeń działu, ukierunkowanych aplikacji analitycznych i obciążeń, w których model danych jest stabilny i dobrze zrozumiały, podejście w pamięci jest prawdziwą siłą.
Jest to scenariusz, wokół którego zbudowano większość demonstracji produktów. Jest to również scenariusz, który mówi najmniej o tym, jak platforma zachowa się rok po produkcji, po wzroście danych baza użytkowników rozszerzyła się, a trzy kolejne aplikacje zostały wdrożone na tym samym serwerze.
Scenariusz skalowania: gdzie architektury się rozchodzą
Własna dokumentacja pomocy technicznej Qlik szczegółowo opisuje model pamięci. Silnik działa na dwóch konfigurowalnych progach znanych jako Zestaw roboczy niski i zestaw roboczy wysoki, z domyślnymi wartościami 70% i 90% fizycznej pamięci RAM odpowiednio. Poniżej niskiego progu silnik zachowuje buforowane obliczenia wyniki agresywnie, na zasadzie, że nieużywaną pamięcią jest zmarnowana pamięć. Po przekroczeniu niskiego progu silnik zaczyna eksmitować wyniki buforowane, aby zrobić miejsce dla nowych, priorytetowo traktując eksmisję według wieku, wielkości i oryginalnego czasu obliczeń. Po przekroczeniu wysokiego progu buforowanie skutecznie zatrzymuje się, a plik strony systemu operacyjnego może być zaangażowany, aby utrzymać silnik przy życiu. Dokumentacja Qlik zauważa, że użycie pliku strony może znacznie pogorszyć wydajność.
Mechanika tego, co dzieje się między tymi progami, ma większe znaczenie niż same progi. Każdy buforowany wynik, który zostanie eksmitowany, jest obliczeniem, które będzie musiało zostać przeliczone przy następnym żądaniu użytkownika. W miarę przyspieszania eksmisji obciążenie obliczeniowe przenosi się z pamięci na procesor. W środowisku o wysokiej współbieżności, w którym wielu użytkowników jednocześnie uruchamia obliczenia, które nie mają już buforowanych odpowiedzi, procesor staje się nowym wąskim gardłem - i w przeciwieństwie do ciśnienia pamięci, ciśnienie procesora manifestuje się bezpośrednio jako widoczne dla użytkownika opóźnienie: pulpity nawigacyjne, które wiszą, filtry, które wymagają sekund, sesje, które kończą się.
Podejście hybrydowe TURBOARD inaczej rozkłada obciążenie. Niezagregowany zbiór danych nie musi zajmować pamięci RAM, ponieważ sklep kolumnowy ma na celu sprawne odpowiadanie na zapytania analityczne z dysku — odczytywanie tylko kolumn, które dotykają zapytania, wykorzystując ciężką kompresję i serwując agregacje z prędkością, która wymagałaby przetwarzania w pamięci dziesięć lat temu. Przyrostowy ładowanie utrzymuje magazyn kolumnowy świeży bez wymuszania powtarzających się pełnych przeładunków, co oznacza, że użytkownicy doświadczają danych bliskich żywotów bez kosztów pamięci związanych z przechowywaniem pełnego zbioru danych w pamięci RAM. Pamięć podręczna Redis przyspiesza następnie zapytania, które najbardziej korzystają z przyspieszenia — które, w każdym rzeczywistym wdrożeniu przedsiębiorstwa, jest niewielkim podzbiorem całkowitego wolumenu zapytań. W następnej części wyjaśniono dlaczego.
Dane na żywo: problem Direct Discovery
Odpowiedzią Qlik na obciążenia, które przekraczają dostępną pamięć, jest Direct Discovery, tryb, w którym pola wymiarów są ładowane do pamięci, podczas gdy pola miary pozostają w bazie źródłowej i są wyszukiwane na żądanie. Intencja projektowa jest rozsądna; udokumentowane ograniczenia są znaczące.
Udokumentowane ograniczenia Direct Discovery (na własne materiały pomocy Qlik):
- Jedno wspólne połączenie bazy danych dla wszystkich użytkowników aplikacji — może zalać bazę danych źródłowych pod dużą współbieżnością.
- Wygenerowany SQL nie jest zoptymalizowany; łączy się między tabelami pamięci i tabelami Direct Discovery mogą tworzyć bardzo duże klauzule IN, które obciążają bufory zapytań bazy danych.
- Kilka podstawowych możliwości analitycznych jest nieobsługiwanych, w tym Set Analysis, Insight Advisor i Dynamic Views.
- Nie planuje się dalszego rozwoju aby zająć się tymi ograniczeniami, zgodnie z oświadczeniem własnym Qlik.
W przypadku TURBOARD łączność na żywo nie jest obejściem ciśnienia pamięci. To pierwszorzędna część architektury. Natywne sterowniki baz danych - zamiast ogólnych połączeń ODBC - zapewniają bezpośredni, wydajny dostęp do systemów źródłowych, w tym platform big data, takich jak Apache Kudu. Mechanizm wyzwalania pamięci podręcznej zapobiega trafieniu bazy danych źródłowej na każde kliknięcie użytkownika: TURBOARD ogląda wyznaczone pole wyzwalacza (takie jak ostatni zaktualizowany znacznik czasu) i obsługuje buforowane wyniki z Redis, gdy dane bazowe nie uległy zmianie, odpytując źródło tylko wtedy, gdy wyzwalacz wskazuje, że dostępne są świeże dane. Zaawansowane funkcje analityczne pozostają w pełni dostępne, niezależnie od tego, czy widget jest odczytem z pamięci podręcznej, ze sklepu kolumnowego, czy ze źródła na żywo. Pojedynczy pulpit może zmieszać wszystkie trzy bez kompromisów.
Wgląd Pareto i patent, który go chroni
W każdym wdrożeniu BI przedsiębiorstwa zachowanie użytkownika przebiega zgodnie z przewidywalnym wzorcem. Około 80% użytkowników wraca wielokrotnie do tych samych podstawowych pulpitów nawigacyjnych — podsumowania wykonawcze, miesięczne sprawozdania z wyników, rollupy regionalne. Pozostałe 20% to użytkownicy power uruchamiający zapytania ad-hoc, które mogą już nigdy nie zostać uruchomione w tej samej formie. Implikacja dla zarządzania pamięcią jest bezpośrednia: nie wszystkie buforowane wyniki są równie cenne, a system, który traktuje je jako równoważne, marnuje swój najdroższy zasób.
Model eksmisji Qlik jest ślepy na zachowanie. Wyniki buforowane są usuwane na podstawie wieku, wielkości i oryginalnego czasu obliczeń - nie w zależności od tego, jak często faktyczni użytkownicy je żądają. Kiedy pamięć wypełnia się, silnik nie może odróżnić pulpitu nawigacyjnego, który codziennie rano sprawdza cały zespół wykonawczy, od jednorazowego zapytania, które zostało ostatnio buforowane.
TURBOARD przyjmuje odwrotne podejście. Za każdym razem, gdy raport jest oglądany, jego wynik popularności jest zwiększany w zestawie sortowanym Redis - strukturze danych zaprojektowanej dokładnie dla tego rodzaju wzorca dostępu do rankingu. System utrzymuje ciągłą tabelę wyników, które raporty są faktycznie używane, i wykorzystuje tę tabelę wyników, aby zdecydować, co pozostaje w pamięci podręcznej, gdy pamięć jest napięta. Najczęściej żądane raporty są chronione w Redis, gdzie powracają z zerowym opóźnieniem do większości użytkowników, którzy są od nich zależni. Zapytania użytkownika zasilania, które nie trafiają w pamięć podręczną, są kierowane do sklepu kolumnowego lub źródła na żywo - oba są zaprojektowane tak, aby szybko odpowiadać na te zapytania bez wypierania treści o wysokiej wartości.
System wyświetlania szybkiego wyszukiwania oparty na sztucznej inteligencji z dostosowaniem do nawyków użytkownika
Mechanizm ten jest przedmiotem przyznanego patentu. System został złożony przez E-Kalite (spółkę macierzystą TURBOARD) w 2022 roku i przyznany w 2025 roku. Patent obejmuje metodę przyspieszenia wyświetlania danych w interfejsie użytkownika, skrócenia czasu ładowania wejścia / wyjścia oraz zmniejszenia częstotliwości dostępu do sprzętu do przechowywania danych i transmisji danych - innymi słowy, połączenie punktacji opartej na użyciu, inteligentnego odświeżania pamięci podręcznej i wykrywania nieświeżości opartego na wyzwalaniu, które pozwala TURBOARDowi obsługiwać obciążenia korporacyjne na budżetach pamięci, które popchnąłoby czysto architektury pamięci na terytorium pliku strony.
Punkt strategiczny jest prosty: gdy pamięć jest obfita, ślepe zachowanie buforowanie kosztuje cię wydajność. Kiedy pamięć jest skąpa, kosztuje wydajność.
Obok siebie
| Pytanie | Podejście Qlik Sense | Podejście TURBOARD |
|---|---|---|
| Gdzie dane żyją w czasie wykonywania? | W pamięci RAM, w całości | W sklepie kolumnowym lub źródle na żywo; wyniki buforowane selektywnie w Redis |
| Co się dzieje, gdy pamięć wypełnia się? | Eksmisja pamięci podręcznej według wieku/rozmiaru, a następnie pagefile | Retencja punktowana przez zachowanie; przepełnienie obsługiwane ze źródła kolumnowego lub źródłowego na żywo |
| Jak obsługiwane jest powtarzające się użycie? | Wynik pamięci podręcznej, eksmitowany na ślepo | Redis cache, zatrzymany przez wynik użycia (opatentowany) |
| Jak utrzymuje się świeżość danych? | Pełne lub QVD-przyrostowe przeładowania do pamięci RAM | Przyrostowe obciążenia kolumnowe + wyzwalacze pamięci podręcznej |
| Jak obsługiwane są zapytania na żywo? | Direct Discovery, z udokumentowanymi limitami | Kierowcy rodzimi, pełna analityka zachowana |
| Skalowanie filozofii | Zapewnij więcej pamięci | Używaj pamięci selektywnie, trasuj resztę |
Wniosek
Qlik Sense pozostaje zdolną platformą analityczną w pamięci, a w warunkach, dla których została zaprojektowana - ograniczone zbiory danych, przewidywalna współbieżność, hojne udostępnianie pamięci - działa dobrze. Pytanie, na które ten post próbował odpowiedzieć, brzmi: co się dzieje, gdy te warunki stają się trudniejsze do spełnienia. Wolumeny danych nie kurczą się. Oczekiwania współbieżności nie są rozluźnione. A koszt i dostępność pamięci, po raz pierwszy od dłuższego czasu, zmierzają w złym kierunku.
Architektura TURBOARD to zakład, że następna dekada wydajności BI wygrają platformy, które Używaj pamięci inteligentnie, a nie obficie. Hybrydowy dostęp do danych, pamięć publiczna, natywna łączność na żywo i opatentowana pamięć podręczna z wykorzystaniem pozwalają TURBOARDowi zapewnić wydajność w skali przedsiębiorstwa w budżetach pamięci, które wyłącznie architektury pamięci mają trudności z życiem.
Dla organizacji, które stoją w obliczu zderzenia rosnących danych, rosnącej współbieżności i zaostrzenia ekonomii sprzętu, ta różnica w podejściu nie jest już akademicka. To różnica między platformą, która skaluje się z biznesem, a platformą, która skaluje się wraz z budżetem zamówień.
Gotowy, aby zobaczyć różnicę?
Jeśli oceniasz Qlik Sense - lub już go uruchamiasz i zaczynasz odczuwać presję pamięci opisaną w tym poście - chcielibyśmy pokazać, jak hybrydowa architektura TURBOARD obsługuje te same obciążenia.
Zarezerwuj przejście z naszym zespołem i zobacz platformę w akcji z własnymi danymi. Bez presji - wolimy, abyś znalazł odpowiednie dopasowanie do konkretnych potrzeb.
Możesz również poznać nasze Pełne porównanie BI strona, aby zobaczyć, jak układamy się w jeszcze większej liczbie scenariuszy przedsiębiorstwa.
Blogi




Przynieś jedno prawdziwe pytanie biznesowe. Zobacz, jak odpowiada TURBOARD.
Demonstrujemy JAS na Twoich raportach, definicjach i kontekście bezpieczeństwa — nie na generycznej, przykładowej bazie.