BIがメモリの壁に直面するとき:RAM不足時代のパフォーマンスを再考する
RAMが安価でなくなり、潤沢に入手できなくなったとき、Qlik Senseのインメモリモデルはどうなるのでしょうか。Qlik自身のドキュメントと取得済みのインテリジェントキャッシュ特許を根拠に、TURBOARDのハイブリッドアーキテクチャと比較します。
過去10年間の大半において、ビジネスインテリジェンスプラットフォームは、メモリがますます安くなり、密度が高くなり、問題に対して簡単に対処できるという、快適な前提に基づいて構築されてきました。 その仮定は静かに崩れつつあります。 AIインフラの構築は、世界のDRAMおよびHBM供給の前例のないシェアを吸収しており、大手メモリメーカー各社は、2026年までに制約がさらに深まる可能性があると警告している。 エンタープライズBIチームにとって、実用的な効果は簡単です。分析プラットフォームが依存するRAMは、より高価になり、より競争が激しくなり、需要に応じてスケーリングが難しくなっています。
これによって重要な問いが変わります。
従来のBI性能の問いは、データセットがメモリに収まるとき、ダッシュボードはどれほど速いかでした。ほぼ必ず「非常に速い」と答えられるため、ベンダーが好む問いです。しかし、本番運用に耐えられるかを左右する問いは変わりました。今問うべきなのは、データ量と同時ユーザー数が増え、メモリを簡単に増設できないとき、プラットフォームはどう動作するかです。
その質問は、今日の市場においてまったく異なる二つの答えがあります。 Qlik Senseは、成熟したインメモリ方式を代表しており、すべてをRAMに内蔵し、そこにとどめ、アソシティブエンジンが近接して速度を発揮できるようにしています。 TURBOARDはハイブリッド方式を代表しており、メモリを最もメリットのあるワークロードのアクセラレーションレイヤーとして扱い、その他のすべてを仕事用に設計されたカラム型ストレージやライブソースにルーティングします。
どちらの考え方も機能します。興味深いのは、周囲の条件が変わったとき、どちらがより長く適応できるかです。本稿では、データ量とユーザー数が増え、RAMが逼迫したときに各アーキテクチャで何が起きるかを、Qlik自身のドキュメントとTURBOARDの公開アーキテクチャを根拠に検討します。
2つのアーキテクチャ、短時間
Qlik SenseはQIXアソシエーティブエンジンを中心に構築されています。 アプリケーションが読み込まれると、非集計されたデータセットはRAMに保持され、すべての値を他のすべての値に結びつける連想構造が保持される。 ユーザーの選択は、これらのメモリ内構造を横断して回答し、計算結果はRAMにキャッシュされるため、その後の同じリクエストが即座に返されます。
Qlikの独自のQVDフォーマットにより、読み込みレイヤーが劇的に高速化され、Qlikドキュメントによると、QVDは他のソースからの読み取り値よりも10〜100倍高速に読み込まれますが、ランタイムモデルでは、物理メモリ内で動作するデータセットを引き続き処理する必要があります。
TURBOARDは異なる方法を採用します。 データは、ネイティブデータベースドライバを使用して最適化されたライブ接続を介してアクセスしたり、MariaDB ColumnStore、ClickHouse、Vertica などの高性能なカラムストアにインポートしたりできます。 頻繁に使用されるクエリ結果は、メモリ内データ構造ストアであるRedisにキャッシュされます。
キャッシュトリガーメカニズムは、キャッシュされた結果がいつ有効であるか、およびソースを再クエリする必要があるタイミングを決定します。 メモリは、すべての分析データのデフォルトホームではなく、最も加速されるワークロードに対して意図的に使用されます。
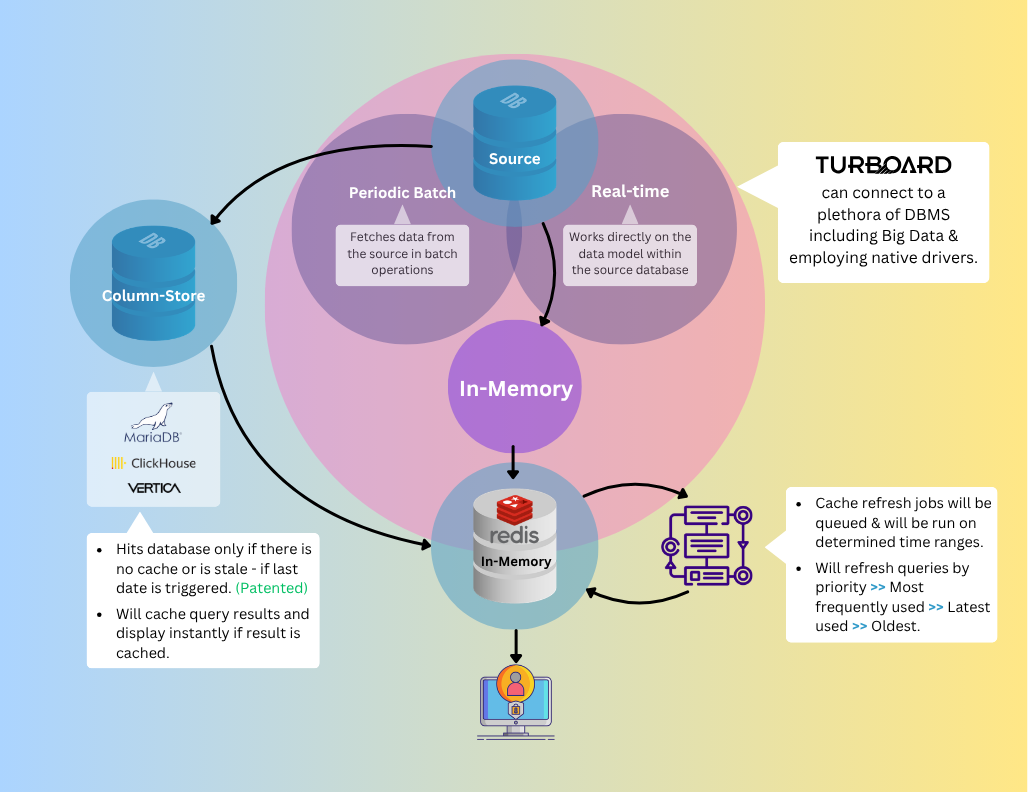
上の図は、TURBOARDの層がどのように調和しているかを示しています。 記事の残りの部分では、周囲の環境が厳しくなるにつれて、各アーキテクチャがどのような機能を持つかを検証します。
公平なシナリオ:インメモリが勝つとき
明確にしておきたいのは、データセットがRAMに余裕を持って収まり、同時利用が適度で、アプリケーションに十分な資源が割り当てられていれば、Qlik Senseは実際に高速だという点です。関連付けエンジンは成熟した技術であり、フィルター操作で集計がミリ秒単位で再計算される体験は、適切な条件では優れています。部門単位の導入、特定用途の分析、安定して理解しやすいデータモデルを使う処理では、インメモリ方式に確かな強みがあります。
これは、ほとんどの製品デモンストレーションが中心に構築されているシナリオです。 また、データが増加し、ユーザー数が拡大し、さらに3つのアプリケーションが同じサーバーに展開されたことから、プラットフォームが本番開始から1年でどのように動作するかを最も判断しにくいシナリオでもあります。
スケーリングシナリオ:アーキテクチャが分岐する場所
Qlikのサポートドキュメントは、メモリモデルを詳細に説明しています。エンジンは設定可能な低作業セットと高作業セットという2つのしきい値に従い、既定値は物理RAMの70%と90%です。下限を下回る間は、未使用メモリは無駄だという考え方で計算結果を積極的にキャッシュします。下限を超えると、経過時間、サイズ、元の計算時間に応じて結果をキャッシュから削除し、新しい結果の領域を確保します。上限を超えるとキャッシュは事実上停止し、エンジンを動作させ続けるためオペレーティングシステムのページファイルが使われる場合があります。Qlikのドキュメントは、ページファイルの使用が性能を大幅に低下させる可能性を指摘しています。
その閾値の間に生じる仕組みは、閾値自体よりも重要である。 キャッシュされた結果はすべて、ユーザーが次にリクエストしたときに再計算が必要な計算です。 立ち退きが加速するにつれて、計算負荷はメモリからCPUへと変化する。 高い並行環境では、多くのユーザーがキャッシュされた回答を残さない計算を同時にトリガーする中で、CPUが新たなボトルネックとなる。メモリ圧力とは異なり、CPUの圧力はユーザー可視の遅延として直接現れる。つまり、応答しなくなるダッシュボード、数秒かけて適用するフィルター、タイムアウトするセッションなどである。
TURBOARDのハイブリッド方式は負荷を別の形で分散します。未集計データセットをRAMに保持する必要はありません。カラムストアはディスク上のデータに対する分析クエリを効率的に処理するよう設計されています。必要な列だけを読み、高い圧縮率を活用して、10年前ならインメモリ処理が必要だった速度で集計します。増分読み込みにより全件の再読み込みを繰り返さずに最新状態を維持できるため、全データをRAMに置くコストをかけず、ほぼリアルタイムのデータを利用できます。Redisは、実際の企業利用では全体の一部を占める、特に高速化の効果が高いクエリを加速します。次節でその理由を説明します。
ライブデータ:ダイレクト・ディスカバリー問題
利用可能なメモリを超えたワークロードに対するQlikの答えはDirect Discoveryであり、このモードでは次元フィールドがメモリに読み込まれ、測定フィールドはソースデータベースに残り、要求に応じてクエリされます。 設計の意図は妥当であり、文書化された制限は重要である。
ダイレクト・ディスカバリーの文書化された制限(Qlik自身の支援資料による):
- 単一共有データベース接続 アプリケーションのすべてのユーザーにとって、ソースデータベースを高い同時実行時に殺到させることができる。
- 生成されたSQLは最適化されていません。 インメモリテーブルとDirect Discoveryテーブル間の接合部は、データベースのクエリバッファにストレインする非常に大きなIN句を生成することができる。
- いくつかの主要な分析能力はサポートされていない。 セット分析、インサイトアドバイザー、ダイナミックビューを含む。
- さらなる開発は予定されていません これらの制限に対処するため、Qlik自身の声明に従って。
ターボードにとって、ライブ接続は記憶力の負担を防ぐ手段ではない。 建築の一流部分です。 ネイティブデータベースのドライバは、一般的なODBC接続ではなく、Apache Kuduのようなビッグデータプラットフォームを含むソースシステムへの直接的かつ高性能なアクセスを提供します。 キャッシュトリガーメカニズムにより、ユーザークリックごとにソースデータベースが毎回照会されるのを防ぎます。TURBOARDは指定されたトリガーフィールド(更新されたタイムスタンプなど)を監視し、基盤となるデータが変更されていないときにRedisのキャッシュ結果を配信し、トリガーが新しいデータが利用可能であることを示す場合にのみ、ソースを照会します。 高度な分析機能は、ウィジェットがキャッシュから、カラムストアから、またはライブソースから読み取り可能かどうかにかかわらず、引き続き完全に利用可能です。 1つのダッシュボードで、妥協することなく3つすべてを混在させることができます。
パレトの洞察と、それを守る特許
エンタープライズBIの展開において、ユーザーの行動は予測可能なパターンに従います。 ユーザーの約80%が同じコアダッシュボードに繰り返し戻っています — エグゼクティブ要約、月次業績報告、地域ごとの展開。 残りの20%は、同じ形式で再度実行されない可能性のあるアドホッククエリを実行している高度な分析を行うユーザーです。 メモリ管理の意味は直接的である。キャッシュされた結果すべてが同様に価値があるわけではない。また、それらを同等のものとして扱うシステムは、最も高価なリソースを無駄にしている。
Qlikの立ち退きモデルは行動盲である。 キャッシュされた結果は、年齢、サイズ、および元の計算時間に基づいて削除されます。これは、実際にユーザーが実際に要求する頻度に基づくものではありません。 メモリが満たされると、エンジンは経営陣が毎朝チェックするダッシュボードと、最近キャッシュされた一過性のクエリと区別することができません。
TURBOARDは逆のアプローチを取っている。 レポートが閲覧されるたびに、その人気スコアはRedis Sorted Setで加算されます。これは、まさにこのようなランクアクセスパターン向けに設計されたデータ構造です。 このシステムは、実際に使用されているレポートを連続して管理し、メモリが逼迫したときにキャッシュ内に何が残るかを決定するために、そのリーダーボードを使用します。 最も要求されたレポートはRedisで保護されており、それらに依存するユーザーの大多数に対してゼロレイテンシで応答します。 キャッシュを見逃した高度な分析を行うユーザーのクエリは、カラムストアまたはライブソースにルーティングされます。どちらも、高値のキャッシュされたコンテンツを置き換えることなく、それらのクエリにすばやく対応するように設計されています。
人工知能を活用した高速検索結果表示システム(ユーザーの習慣への適応)
この仕組みは取得済み特許の対象です。 このシステムは2022年にE-Kalite(TURBOARDの親会社)によって申請され、2025年に登録されました。 この特許は、ユーザーインターフェースにおけるデータ表示の高速化、入出力の読み込み時間の短縮、データの保存および送信を行うハードウェアへのアクセス頻度の短縮、つまり、使用状況に基づくスコアリング、インテリジェントなキャッシュ更新、およびトリガーに基づくデータの陳腐化検知を組み合わせることで、TURBOARDがエンタープライズワークロードにメモリ予算で対応できるようにし、純粋なインメモリアーキテクチャをページファイル領域へと移行させる方法について扱っています。
戦略的な要点は明確です。メモリが豊富なとき、利用行動を考慮しないキャッシュは効率を犠牲にします。メモリが不足するときは、性能を犠牲にします。
隣り合って
| 質問 | Qlik Senseアプローチ | TURBOARD方式 |
|---|---|---|
| 実行時にデータはどこに存在しますか? | RAMで、完全に | カラムストアまたはライブソースで、結果はRedisで選択的にキャッシュされました |
| メモリがいっぱいになるとどうなりますか? | 年齢/サイズ別のキャッシュによる立ち退き、その後ページファイル | 利用スコアに応じて保持し、残りの要求はカラムストアまたはライブソースで処理 |
| 繰り返し使用はどのように処理されますか? | インメモリの結果キャッシュ。利用状況を考慮せず削除 | 使用スコア(特許取得済み)によって保持されるRedisキャッシュ |
| データの新鮮さはどのように維持されますか? | RAMへのフルまたはQVD増分リロード | 増分カラムの読み込み+キャッシュトリガー |
| ライブクエリはどのように処理されますか? | 文書化された限界を持つ直接発見 | ネイティブドライバー、完全なアナリティクスが保持される |
| スケーリングの考え方 | メモリを増設 | メモリを選択的に使用し、残りをルーティングします |
結論
Qlik Senseは、依然として高性能なインメモリ分析プラットフォームであり、バインドドデータセット、予測可能な同時実行性、大容量メモリのプロビジョニングなど、さまざまな条件で優れた性能を発揮します。 この投稿が答えようとした質問は、そうした状況が重なりにくくなるにつれてどうなるかということです。 データ量が縮小しているわけではない。 並行投資の期待は緩むものではない。 そして、メモリのコストと可用性が、久しぶりに誤った方向に進んでいる。
TURBOARDのアーキテクチャは、今後10年間のBI性能を制するのは大量のメモリに頼るのではなく、メモリを賢く使うプラットフォームだと考えています。ハイブリッドデータアクセス、カラムストレージ、ネイティブライブ接続、特許取得済みの利用スコア型キャッシュにより、純粋なインメモリ方式では対応しにくいメモリ予算でTURBOARDは企業規模の性能を提供します。
データの増加、並行性の高まり、ハードウェア経済の逼迫に直面している組織にとって、そのアプローチの違いはもはや理論上だけの問題ではありません。 ビジネスに合わせてスケーリングするプラットフォームと、調達予算に合わせてスケーリングするプラットフォームの違いです。
違いを見る準備はできましたか?
Qlik Senseを評価している場合、あるいはすでにそれを実行中で、この記事で説明されているメモリの圧力を感じ始めている場合、TURBOARDのハイブリッドアーキテクチャが同じワークロードをどのように処理しているかをぜひお見せします。
当社チームによるデモをご予約いただき、ご自身のデータでプラットフォームの動作をご覧ください。無理に導入をお勧めすることはありません。お客様の要件に合う選択肢を見つけていただきたいと考えています。
さらに、BIの総合比較ページでは、他の企業向けシナリオでの違いもご確認いただけます。



実際のビジネス課題をひとつお持ちください。TURBOARDがどう答えるかをお見せします。
汎用のサンプルデータではなく、貴社のレポート、定義、セキュリティ設定を使ってJASをデモンストレーションします。