Когда BI упирается в ограничение памяти: новый взгляд на производительность при дефиците RAM
Что происходит с моделью памяти Qlik Sense, когда оперативная память больше не дешевая или бесконечно доступная? Мы сравниваем его с гибридной архитектурой TURBOARD, используя собственную документацию Qlik и наш патент на интеллектуальное кэширование.
Большую часть последнего десятилетия платформы бизнес-аналитики были построены на удобном предположении: память будет становиться дешевле, плотнее и проще добавлять для решения задач. Это предположение тихо нарушается. Создание инфраструктуры ИИ поглощает беспрецедентную долю глобальных поставок DRAM и HBM, и крупные производители памяти предупреждают, что ограничения, вероятно, будут углубляться до 2026 года. Для корпоративных BI-команд практический эффект прост — RAM, от которого зависит ваша аналитическая платформа, становится все более дорогим, более востребованным и труднее наращиваемым по требованию.
Это меняет вопрос, который имеет значение.
Традиционный вопрос производительности BI был: Насколько быстра панель управления, когда набор данных вписывается в память? Это вопрос, который любят продавцы, потому что ответ почти всегда «очень быстрый». Но это уже не вопрос, который решает, будет ли платформа держаться в производстве. Реальный вопрос сейчас: Как работает платформа, когда объемы данных растут, одновременные пользователи умножаются, а память - это ресурс, который вы не можете просто купить больше?
У этого вопроса есть два совершенно разных ответа на рынке сегодня. Qlik Sense представляет зрелую школу в памяти — загрузите все в оперативную память, сохраните его там и позвольте ассоциативному двигателю обеспечить скорость через близость. TURBOARD представляет собой гибридную школу — рассматривать память как слой ускорения для рабочих нагрузок, которые больше всего выигрывают, и направлять все остальное в хранилище столбцов или живые источники, предназначенные для работы.
Обе философии работают. Интересный вопрос заключается в том, какой из них стареет лучше по мере изменения условий вокруг него. Этот пост проходит через то, что на самом деле происходит с каждой архитектурой по мере роста данных, увеличения пользователей, а оперативная память становится тесной - используя собственную документацию Qlik и опубликованную архитектуру TURBOARD в качестве доказательств.
Две архитектуры, вкратце
Qlik Sense построен вокруг ассоциативного движка QIX. Когда приложение загружается, неагрегированный набор данных хранится в оперативной памяти, а также в ассоциативных структурах, которые связывают каждое значение с любым другим значением. Выбор пользователей обрабатывается обходом эти структуры в памяти, а результаты расчетов кэшируются в оперативной памяти, поэтому последующие идентичные запросы возвращаются мгновенно.
Собственный формат QVD Qlik значительно ускоряет загрузку — документация Qlik сообщает, что QVD читается в десять-сто раз быстрее, чем считывается из других источников, — но модель времени выполнения по-прежнему требует хранения рабочего набора данных в физической памяти.
TURBOARD идет по другому пути. Доступ к данным может быть получен через оптимизированные живые соединения с использованием собственных драйверов баз данных или импортирован в высокопроизводительный колоночное хранилище, такой как MariaDB ColumnStore, ClickHouse или Vertica. Часто используемые результаты запроса кэшируются в Redis, хранилище структуры данных в памяти.
Механизм кэш-триггера решает, когда кэшированные результаты все еще действительны и когда источник должен быть повторно запрашиваем. Память используется намеренно, для рабочих нагрузок, где она производит наибольшее ускорение, а не как дом по умолчанию для всех аналитических данных.
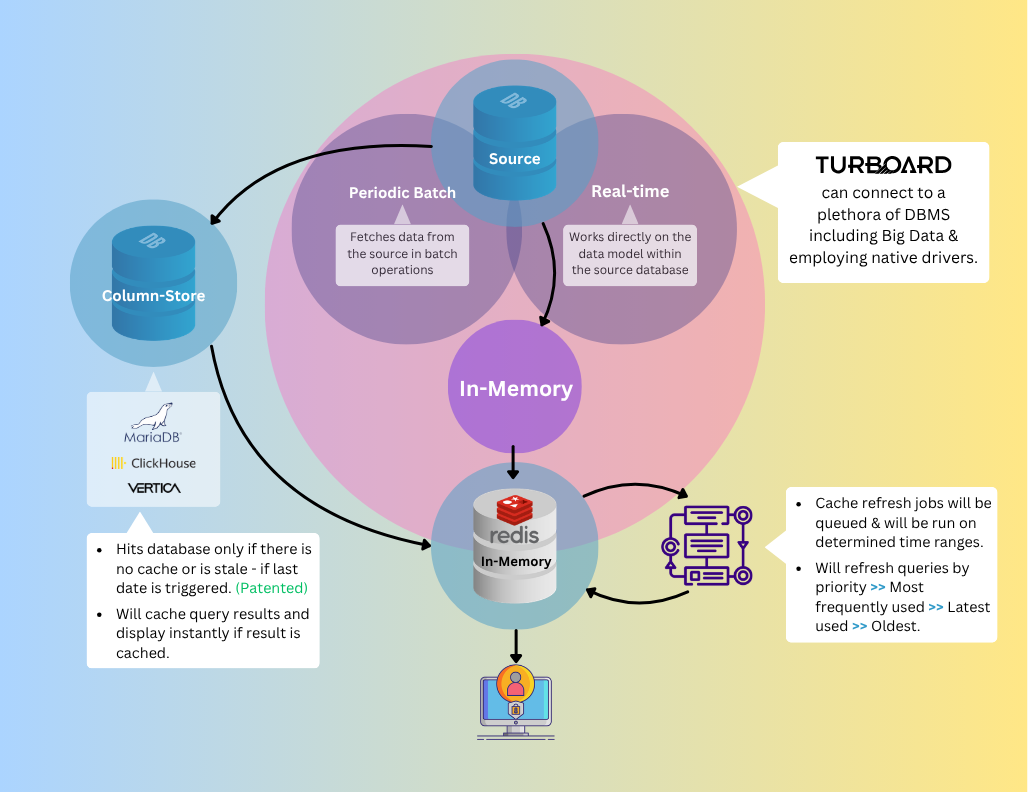
На диаграмме выше показано, как слои TURBOARD подходят друг другу. В остальной части поста рассматривается, что делает каждая архитектура, поскольку условия вокруг нее становятся все труднее.
Благоприятный сценарий: когда выигрывает обработка в памяти
Стоит четко сказать: когда набор данных удобно вписывается в оперативную память, когда число одновременных пользователей невелико, а когда среда рассчитана на применение, Qlik Sense действительно быстр. Ассоциативный движок является зрелым элементом инженерии, и пользовательский опыт щелчка фильтров и наблюдения за агрегациями, пересчитывающимися за миллисекунды, в свой день превосходен. Для развертывания в департаментах, сфокусированных аналитических приложений и рабочих нагрузок, где модель данных стабильна и хорошо понятна, подход в памяти является реальной силой.
Это сценарий, вокруг которого построено большинство демонстраций продуктов. Это также сценарий, который меньше всего говорит о том, как платформа будет вести себя через год в производстве, после того, как данные выросли, база пользователей расширилась, и еще три приложения были развернуты на одном и том же сервере.
Масштабируемый сценарий: где архитектуры расходятся
Собственная вспомогательная документация Qlik подробно описывает модель памяти. Двигатель работает против двух конфигурируемых порогов, известных как Рабочий набор низкий и рабочий набор высокий, со значениями дефолта 70% и 90% физической оперативной памяти соответственно. Ниже низкого порога двигатель агрессивно сохраняет результаты кэшированных вычислений, исходя из принципа, что неиспользуемая память является потраченной впустую памятью. Как только низкий порог пересекается, двигатель начинает выселять кэш-результаты, чтобы освободить место для новых, уделяя приоритетное внимание выселению по возрасту, размеру и первоначальному времени расчета. Как только высокий порог пересекается, кэширование эффективно останавливается, и файл подкачки операционной системы может быть задействована для поддержания работы двигателя. Документация Qlik отмечает, что использование файла подкачки может значительно ухудшить производительность.
Механика того, что происходит между этими порогами, имеет большее значение, чем сами пороги. Каждый кэшированный результат, который будет выселен, - это расчет, который необходимо будет выполнить повторно в следующий раз, когда пользователь запросит его. По мере ускорения выселения вычислительная нагрузка переходит от памяти к процессору. В среде с большим числом одновременных пользователей, где многие пользователи одновременно запускают вычисления, которые больше не имеют кэшированных ответов, процессор становится новым узким местом — и в отличие от давления памяти, давление процессора проявляется непосредственно как задержка пользователя: панели приборов, которые висят, фильтры, которые занимают секунды, чтобы применить, сеансы с истекшим временем ожидания.
Гибридный подход TURBOARD распределяет нагрузку по-разному. Неагрегированный набор данных не должен занимать ОЗУ, поскольку колоночное хранилище предназначен для эффективного ответа на аналитические запросы с диска — чтение только столбцов, к которым обращается запрос, эксплуатируя сильное сжатие и подавая агрегации со скоростью, которая потребовала бы обработки в памяти десять лет назад. Постепенная загрузка сохраняет колоночное хранилище свежим без принуждения к повторным полным загрузкам, что означает, что пользователи получают данные, близкие к реальному времени без стоимости памяти для хранения полного набора данных в оперативной памяти. Затем кэш Redis ускоряет запросы, которые больше всего выигрывают от ускорения, что в любом реальном развертывании предприятия представляет собой небольшое подмножество общего объема запросов. Следующий раздел объясняет, почему.
Живые данные: проблема прямого обнаружения
Ответом Qlik на рабочие нагрузки, которые превышают доступную память, является Direct Discovery, режим, в котором поля размерности загружаются в память, в то время как поля измерения остаются в базе данных источника и запрашиваются по требованию. Замысел обоснован; документированные ограничения значительны.
Документированные ограничения прямого открытия (в соответствии с собственными справочными материалами Qlik):
- Единое совместное соединение базы данных для всех пользователей приложения — может затопить базу данных источника при большом числе одновременных запросов.
- Генерируемый SQL не оптимизирован; соединения между таблицами памяти и таблицами прямых открытий могут создавать очень большие пункты IN, которые напрягают буферы запросов базы данных.
- Несколько основных аналитических возможностей не подкреплены. включая наборный анализ, Insight Advisor и динамические взгляды.
- Дальнейшее развитие не планируется Для устранения этих ограничений, согласно собственному заявлению Qlik.
Для TURBOARD живое подключение не является обходным путем для давления памяти. Это первоклассная часть архитектуры. Нативные драйверы баз данных, а не общие соединения ODBC, обеспечивают прямой, высокопроизводительный доступ к исходным системам, включая платформы больших данных, такие как Apache Kudu. Механизм кэш-триггера предотвращает обращение к исходной базе данных при каждом щелчке пользователя: TURBOARD наблюдает за обозначенным триггерным полем (например, последней обновленной меткой времени) и обслуживает кэшированные результаты от Redis, когда основные данные не изменились, задавая запрос источнику только тогда, когда триггер указывает на наличие свежих данных. Расширенные аналитические функции остаются полностью доступными независимо от того, читается ли виджет из кэша, из колоночного хранилища или из живого источника. Одна панель управления может смешивать все три без компромиссов.
Прозрение Парето и патент, который его защищает
В любом развертывании BI предприятия поведение пользователя следует предсказуемой схеме. Примерно 80% пользователей неоднократно возвращаются на одни и те же основные панели инструментов — сводки для руководства, ежемесячные отчеты о результатах работы, региональные сводки. Остальные 20% - это опытные пользователи, выполняющие сложные запросы, которые, возможно, никогда не будут запущены снова в той же форме. Подразумевается, что управление памятью является прямым: не все кэшированные результаты одинаково ценны, и система, которая рассматривает их как эквивалент, тратит свой самый дорогой ресурс.
Модель выселения Qlik является слепой к поведению. Кэшированные результаты удаляются на основе возраста, размера и первоначального времени вычисления, а не на том, как часто фактически пользователи их запрашивают. Когда память заполняется, двигатель не может различать приборную панель, которую каждое утро проверяет вся исполнительная команда, от одноразового запроса, который недавно был кэширован.
TURBOARD придерживается противоположного подхода. Каждый раз, когда отчет просматривается, его оценка популярности увеличивается в Redis Sorted Set - структуре данных, предназначенной именно для такого рода рисунка с ранжированным доступом. Система ведет постоянно обновляемый рейтинг фактически используемых отчетов, и использует эту таблицу лидеров, чтобы решить, что остается в кэше, когда памяти не хватает. Наиболее запрашиваемые отчеты защищены в Redis, где они возвращаются с нулевой задержкой большинству пользователей, которые зависят от них. Запросы опытных пользователей, для которых нет результата в кэше, направляются в колоночное хранилище или живой источник — оба из которых разработаны, чтобы быстро отвечать на эти запросы, не вытесняя высокоценный кэшированный контент.
Система быстрого отображения результатов быстрого поиска с адаптацией к пользовательским привычкам
Этот механизм является предметом выданного патента. Система была подана компанией E-Kalite (материнская компания TURBOARD) в 2022 году и предоставлена в 2025 году. Патент охватывает метод ускорения отображения данных на пользовательском интерфейсе, сокращения времени загрузки ввода/вывода и снижения частоты доступа к аппаратному обеспечению для хранения данных и передачи данных — другими словами, сочетание оценки на основе использования, интеллектуального обновления кэша и обнаружения устаревших данных на основе триггеров, что позволяет TURBOARD обслуживать рабочие корпоративные нагрузки в рамках объемов памяти, которые будут продвигать чисто в памяти архитектуры к использованию файла подкачки.
Стратегический момент прост: когда память в изобилии, кэширование вслепую требует вашей эффективности. Когда память скудна, это стоит вам производительности.
Бок о бок
| Вопрос | Подход Qlik Sense | Подход TURBOARD |
|---|---|---|
| Где живут данные во время выполнения? | В оперативной памяти, в полном объеме | В колоночном хранилище или исходной системе; результаты выборочно кэшируются в Redis |
| Что происходит, когда память заполняется? | Выселение кэша по возрасту/размеру, затем файл подкачки | Удержание по оценке использования; остальные запросы обслуживаются колоночным хранилищем или исходной системой |
| Как обрабатывается повторное использование? | Кэш результатов в памяти с вытеснением без учета использования | Кэш Redis, сохраненный по оценке частоты использования (запатентован) |
| Как сохраняется свежесть данных? | Полные или QVD-инкрементальные перезагрузки в оперативную память | Инкрементальная загрузка колоночного хранилища + триггеры кэша |
| Как обрабатываются живые запросы? | Прямое открытие, с документированными лимитами | Нативные драйверы, полная аналитика сохранена |
| Масштабная философия | Обеспечить больше памяти | Используйте память выборочно, маршрутируйте остальное |
Заключение
Qlik Sense остается способной аналитической платформой в памяти, и в условиях, для которых она была разработана — ограниченные наборы данных, предсказуемая единая параллельность, достаточный объем выделенной памяти — она работает хорошо. Вопрос, на который этот пост пытался ответить, заключается в том, что происходит, когда эти условия становятся все труднее выполнить. Объемы данных не сокращаются. Требования к одновременной работе пользователей не снижаются. А стоимость и доступность памяти, впервые за долгое время, движутся в неправильном направлении.
Архитектура TURBOARD — ставка на то, что в следующем десятилетии BI успеха добьются платформы, которые используют память разумно, а не в больших объемах. Гибридный доступ к данным, колоночное хранение, нативные подключения к источникам и запатентованный кэш с оценкой использования позволяют TURBOARD обеспечивать корпоративную производительность при объемах памяти, с которыми архитектуры исключительно в памяти справляются с трудом.
Для организаций, сталкивающихся с столкновением растущих данных, ростом числа одновременных пользователей и ужесточением экономики оборудования, эта разница в подходе больше не является академической. Это разница между платформой, которая масштабируется с бизнесом, и платформой, которая масштабируется с бюджетом закупок.
Готовы увидеть разницу?
Если вы оцениваете Qlik Sense — или уже запускаете его и начинаете чувствовать давление памяти, описанное в этом посте — мы хотели бы показать вам, как гибридная архитектура TURBOARD обрабатывает те же рабочие нагрузки.
Закажите демонстрацию с нашей командой и посмотрите на платформу в действии с вашими собственными данными. Никакого давления — мы бы предпочли, чтобы вы нашли подходящее для ваших конкретных потребностей.
Вы также можете открыть страницу полного сравнения BI, чтобы узнать, как мы выглядим в других корпоративных сценариях.
Блоги



Принесите один реальный бизнес-вопрос. Посмотрите, как на него ответит TURBOARD.
Мы демонстрируем JAS на ваших отчётах, ваших определениях и вашем контексте безопасности — а не на типовой демонстрационной базе.