O que acontece com o modelo de memória da Qlik Sense quando a RAM não é mais barata ou infinitamente disponível? Comparamos com a arquitetura híbrida da TURBOARD usando a própria documentação da Qlik e nossa patente concedida sobre cache inteligente.
Durante a maior parte da última década, as plataformas de inteligência de negócios foram construídas com base em uma suposição confortável: a memória continuaria ficando mais barata, mais densa e mais fácil de lançar problemas. Essa suposição está silenciosamente quebrando. Os buildouts de infraestrutura de IA estão absorvendo uma parcela sem precedentes do fornecimento global de DRAM e HBM, e os principais fabricantes de memória alertaram que as restrições provavelmente se aprofundarão até 2026. Para as equipes de BI corporativas, o efeito prático é simples – a RAM da qual sua plataforma de análise depende está se tornando mais cara, mais contestada e mais difícil de escalar sob demanda.
Isso muda a questão que importa.
A questão tradicional de desempenho do BI foi: Quão rápido é o painel quando o conjunto de dados se encaixa na memória? É a pergunta que os vendedores adoram, porque a resposta é quase sempre “muito rápida”. Mas não é mais a questão que decide se uma plataforma vai se manter em produção. A verdadeira questão agora é: como a plataforma se comporta quando os volumes de dados crescem, os usuários simultâneos se multiplicam e a memória é o recurso que você não pode simplesmente comprar mais?
Essa pergunta tem duas respostas muito diferentes no mercado hoje. O Qlik Sense representa a escola madura na memória – carregue tudo na RAM, mantenha-a lá e deixe um motor associativo oferecer velocidade através da proximidade. TURBOARD representa uma escola híbrida – trate a memória como uma camada de aceleração para as cargas de trabalho que mais beneficiam e roteie todo o resto para armazenamento colunar ou fontes ao vivo projetadas para o trabalho.
Ambas as filosofias funcionam. A questão interessante é qual envelhece melhor à medida que as condições em torno dela mudam. Este post percorre o que realmente acontece com cada arquitetura à medida que os dados crescem, os usuários aumentam e a RAM fica apertada – usando a própria documentação da Qlik e a arquitetura publicada da TURBOARD como evidência.
Duas arquiteturas, brevemente
O Qlik Sense é construído em torno do motor associativo QIX. Quando um aplicativo é carregado, o conjunto de dados não agregado é mantido em RAM, juntamente com as estruturas associativas que vinculam cada valor a todos os outros valores. As seleções de usuários são respondidas atravessando essas estruturas de memória, e os resultados de cálculo são armazenados em cache na RAM, portanto, as solicitações idênticas subsequentes retornam instantaneamente.
O próprio formato QVD da Qlik acelera a camada de carregamento drasticamente – a documentação do Qlik relata que o QVD é lido de dez a cem vezes mais rápido do que as leituras de outras fontes – mas o modelo de tempo de execução ainda requer que o conjunto de dados de trabalho viva na memória física.
TURBOARD assume um caminho diferente. Os dados podem ser acessados por meio de conexões ao vivo otimizadas usando drivers de banco de dados nativos ou importados para uma loja colunar de alto desempenho, como MariaDB ColumnStore, ClickHouse ou Vertica. Resultados de consulta usados com frequência são armazenados em cache no Redis, o armazenamento de estrutura de dados na memória.
Um mecanismo de cache-trigger decide quando os resultados em cache ainda são válidos e quando a fonte precisa ser consultada novamente. A memória é usada deliberadamente, para as cargas de trabalho onde produz mais aceleração – não como a casa padrão para todos os dados analíticos.
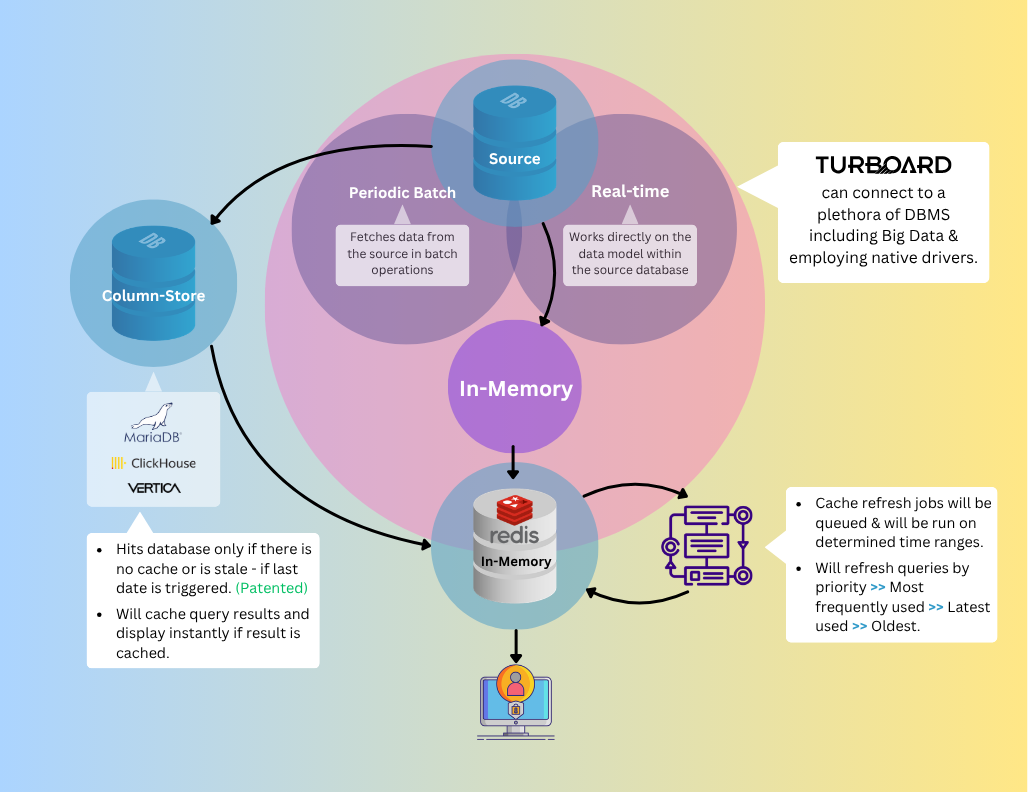
O diagrama acima mostra como as camadas da TURBOARD se encaixam. O resto do post examina o que cada arquitetura faz à medida que as condições em torno dela ficam mais difíceis.
O cenário justo: quando a memória vence
Vale a pena dizer claramente: quando o conjunto de dados se encaixa confortavelmente na RAM, quando a concorrência é modesta e quando o ambiente é dimensionado para o aplicativo, o Qlik Sense é genuinamente rápido. O motor associativo é uma peça madura de engenharia, e a experiência do usuário de clicar através de filtros e assistir a agregações recalculadas em milissegundos é, em seu dia, excelente. Para implantações departamentais, aplicativos analíticos focados e cargas de trabalho onde o modelo de dados é estável e bem compreendido, a abordagem na memória é uma força real.
Este é o cenário em que a maioria das demonstrações de produtos é construída. É também o cenário que menos informa como uma plataforma se comportará um ano em produção, depois que os dados crescerem, a base de usuários se expandiu e mais três aplicativos foram implantados no mesmo servidor.
O cenário de escala: onde as arquiteturas divergem
A própria documentação de suporte da Qlik descreve o modelo de memória em detalhes. O motor opera contra dois limiares configuráveis conhecidos como Conjunto de trabalho baixo e conjunto de trabalho alto, com valores padrão de 70% e 90% da RAM física respectivamente. Abaixo do limiar baixo, o motor mantém resultados de cálculo em cache de forma agressiva, com o princípio de que a memória não utilizada é a memória desperdiçada. Uma vez que o limite baixo é cruzado, o motor começa a despejar resultados em cache para abrir espaço para novos, priorizando o despejo por idade, tamanho e tempo de cálculo original. Uma vez que o limiar alto é ultrapassado, o cache efetivamente pára, e o arquivo de página do sistema operacional pode ser contratado para manter o motor vivo. A documentação da Qlik observa que o uso do arquivo de página pode degradar o desempenho significativamente.
A mecânica do que acontece entre esses limiares importa mais do que os próprios limiares. Cada resultado em cache que é despejado é um cálculo que precisará ser recomputado na próxima vez que um usuário solicitar. À medida que o despejo acelera, a carga computacional muda da memória para a CPU. Em um ambiente de alta concorrência, onde muitos usuários estão simultaneamente acionando cálculos que não têm mais respostas em cache, a CPU se torna o novo gargalo – e, ao contrário da pressão da memória, a pressão da CPU se manifesta diretamente como latência visível pelo usuário: painéis que pairam, filtros que levam segundos para serem aplicados, sessões que passam o tempo.
A abordagem híbrida da TURBOARD distribui a carga de forma diferente. O conjunto de dados não agregado não precisa ocupar RAM, porque a loja colunar é projetada para responder a consultas analíticas de forma eficiente a partir do disco — ler apenas as colunas que uma consulta toca, explorando a compressão pesada e servindo agregações em velocidades que exigiriam o processamento na memória há uma década. A carga incremental mantém a loja colunar fresca sem forçar repetidas recargas completas, o que significa que os usuários experimentam dados próximos sem o custo de memória de manter o conjunto de dados completo na RAM. O cache do Redis então acelera as consultas que mais se beneficiam da aceleração – que, em qualquer implantação de empresa real, é um pequeno subconjunto do volume total de consultas. A próxima seção explica o porquê.
Dados ao vivo: o problema do Direct Discovery
A resposta da Qlik para cargas de trabalho que excedem a memória disponível é o Direct Discovery, um modo em que os campos de dimensão são carregados na memória enquanto os campos de medida permanecem no banco de dados de origem e são consultados sob demanda. A intenção do projeto é razoável; as limitações documentadas são significativas.
Limitações documentadas do Direct Discovery (por materiais de ajuda da própria Qlik):
- Única conexão de banco de dados compartilhada para todos os usuários de um aplicativo — pode inundar o banco de dados de origem sob alta concorrência.
- SQL gerado não é otimizado; joins entre tabelas in-memory e Direct Discovery tabelas podem produzir cláusulas IN muito grandes que desencamem buffers de consulta de banco de dados.
- Várias capacidades analíticas centrais não são suportadas, incluindo Análise de Conjuntos, Insight Advisor e Visualizações Dinâmicas.
- Nenhum desenvolvimento adicional está planejado para abordar essas limitações, de acordo com a própria declaração da Qlik.
Para a TURBOARD, a conectividade ao vivo não é uma solução alternativa para a pressão da memória. É uma parte de primeira classe da arquitetura. Os drivers de banco de dados nativos – em vez de conexões ODBC genéricas – fornecem acesso direto e de alto desempenho a sistemas de origem, incluindo plataformas de big data como o Apache Kudu. O mecanismo de cache-trigger impede que o banco de dados de origem seja atingido em cada clique do usuário: o TURBOARD assiste a um campo de gatilho designado (como um carimbo de data e hora atualizado pela última vez) e serve resultados em cache do Redis quando os dados subjacentes não foram alterados, consultando a fonte apenas quando o gatilho indica que os dados novos estão disponíveis. Os recursos analíticos avançados permanecem totalmente disponíveis se um widget está lendo a partir do cache, da loja colunar ou de uma fonte ao vivo. Um único painel pode misturar todos os três sem compromisso.
O insight de Pareto e a patente que o protege
Em qualquer implantação de BI empresarial, o comportamento do usuário segue um padrão previsível. Cerca de 80% dos usuários retornam repetidamente aos mesmos painéis principais — resumos executivos, relatórios mensais de desempenho, produtos rolânicos regionais. Os 20% restantes são usuários avançados executando consultas ad-hoc que podem nunca mais ser executadas novamente na mesma forma. A implicação para o gerenciamento de memória é direta: nem todos os resultados em cache são igualmente valiosos, e um sistema que os trata como equivalentes está desperdiçando seu recurso mais caro.
O modelo de despejo da Qlik é cego para o comportamento. Os resultados em cache são removidos com base na idade, tamanho e tempo de cálculo original – não com base na frequência com que os usuários reais realmente os solicitam. Quando a memória é preenchida, o mecanismo não pode distinguir o painel que toda a equipe executiva verifica todas as manhãs de uma consulta pontual que foi armazenada em cache recentemente.
TURBOARD assume a abordagem oposta. Toda vez que um relatório é visualizado, sua pontuação de popularidade é incrementada em um Redis Sorted Set – uma estrutura de dados projetada exatamente para esse tipo de padrão de acesso classificado. O sistema mantém uma tabela de classificação contínua de quais relatórios estão realmente sendo usados e usa essa tabela de classificação para decidir o que fica no cache quando a memória está apertada. Os relatórios mais solicitados estão protegidos em Redis, onde retornam com latência zero para a maioria dos usuários que dependem deles. As consultas do usuário de energia que perdem o cache são roteadas para o armazenamento colunar ou para a fonte ao vivo – ambas projetadas para responder a essas consultas rapidamente sem deslocar o conteúdo em cache de alto valor.
Sistema de exibição de resultados de pesquisa rápida alimentado por inteligência artificial com adaptação aos hábitos do usuário
Este mecanismo é objeto de uma patente concedida. O sistema foi arquivado pela E-Kalite (empresa-mãe da TURBOARD) em 2022 e concedido em 2025. A patente abrange o método de acelerar a exibição de dados na interface do usuário, encurtando os tempos de carregamento de entrada / saída e reduzindo a frequência de acesso ao armazenamento de dados e ao hardware transmissor de dados – em outras palavras, a combinação de pontuação baseada em uso, atualização de cache inteligente e detecção de obstinação baseada em gatilho que permite que o TURBOARD atenda cargas de trabalho corporativas em orçamentos de memória que empurrariam arquiteturas puramente na memória para o território do pagefile.
O ponto estratégico é simples: quando a memória é abundante, o cache cego de comportamento custa eficiência. Quando a memória é escassa, custa-lhe o desempenho.
Lado a lado
| Pergunta | Abordagem do Sentido Qlik | Abordagem TURBOARD |
|---|---|---|
| Onde os dados vivem em tempo de execução? | Em RAM, na íntegra | Na loja colunar ou na fonte ao vivo; resultados armazenados em cache seletivamente no Redis |
| O que acontece quando a memória enche? | Despejo de cache por idade / tamanho, em seguida, pagefile | Retenção pontuada no comportamento; transbordamento servido a partir de fonte colunar ou ao vivo |
| Como o uso repetido é tratado? | Cache de resultados na memória, despejado cegamente | Cache Redis, retido pela pontuação de uso (patenteado) |
| Como é mantido o frescor dos dados? | Recargas completas ou incrementais QVD na memória RAM | Cargas colunares incrementais + gatilhos de cache |
| Como são tratadas as consultas ao vivo? | Descoberta direta, com limites documentados | Motoristas nativos, análise completa retida |
| Filosofia de escala | Provisionar mais memória | Use a memória seletivamente, roteie o resto |
Conclusão
O Qlik Sense continua sendo uma plataforma de análise de memória capaz e, nas condições para as quais foi projetada – conjuntos de dados limitados, concorrência previsível, provisionamento generoso de memória – tem um bom desempenho. A pergunta que este post tentou responder é o que acontece à medida que essas condições se tornam mais difíceis de atender. Os volumes de dados não estão diminuindo. Expectativas de concorrência não são relaxantes. E o custo e a disponibilidade de memória, pela primeira vez em muito tempo, estão se movendo na direção errada.
A arquitetura da TURBOARD é uma aposta de que a próxima década de desempenho do BI será ganha por plataformas que usar a memória de forma inteligente em vez de abundantemente. O acesso híbrido a dados, o armazenamento colunar, a conectividade ao vivo nativa e um cache patenteado com pontuação de uso permitem que o TURBOARD ofereça desempenho em escala empresarial em orçamentos de memória que as arquiteturas puramente na memória lutam para viver dentro.
Para as organizações que enfrentam a colisão de dados crescentes, a crescente concorrência e o aperto da economia de hardware, essa diferença de abordagem não é mais acadêmica. É a diferença entre uma plataforma que escala com o negócio e uma plataforma que escala com o orçamento de compras.
Pronto para ver a diferença?
Se você está avaliando o Qlik Sense – ou já executando-o e começando a sentir a pressão da memória descrita neste post – gostaríamos de mostrar como a arquitetura híbrida da TURBOARD lida com as mesmas cargas de trabalho.
Reserve um passo a passo com nossa equipe e veja a plataforma em ação com seus próprios dados. Sem pressão – preferimos que você encontre o ajuste certo para suas necessidades específicas.
Você também pode explorar o nosso Comparação completa do BI página para ver como nos acumulamos em ainda mais cenários corporativos.
Blogs




Traga uma pergunta de negócio real. Veja como o TURBOARD responde.
Demonstramos a JAS sobre os seus relatórios, as suas definições e o seu contexto de segurança — não sobre um banco de exemplo genérico.