Saat BI Mencapai Batas Memori: Meninjau Ulang Performa di Tengah Keterbatasan RAM
Apa yang terjadi pada model memori Qlik Sense ketika RAM tidak lagi murah atau tersedia tanpa henti? Kami membandingkannya dengan arsitektur hibrida TURBOARD menggunakan dokumentasi Qlik sendiri dan paten kami yang diberikan pada caching cerdas.
Untuk sebagian besar dekade terakhir, platform intelijen bisnis dibangun di atas asumsi yang nyaman: memori akan terus menjadi lebih murah, lebih padat, dan lebih mudah ditambah untuk mengatasi masalah. Asumsi itu diam-diam pecah. Pembangunan infrastruktur AI menyerap bagian yang belum pernah terjadi sebelumnya dari pasokan DRAM dan HBM global, dan produsen memori utama telah memperingatkan bahwa kendala kemungkinan akan semakin dalam hingga 2026. Untuk tim BI perusahaan, efek praktisnya sederhana - RAM yang menjadi tumpuan platform analitik Anda menjadi lebih mahal, lebih diperebutkan, dan lebih sulit untuk diskalakan sesuai permintaan.
Hal ini mengubah pertanyaan yang penting.
Pertanyaan kinerja BI tradisional adalah: Seberapa cepat dashboard ketika dataset cocok dalam memori? Ini adalah pertanyaan yang disukai vendor, karena jawabannya hampir selalu “sangat cepat.” Tapi itu bukan lagi pertanyaan yang memutuskan apakah platform akan bertahan dalam produksi. Pertanyaan sebenarnya sekarang adalah: Bagaimana platform berperilaku ketika volume data tumbuh, pengguna bersamaan berlipat ganda, dan memori adalah sumber daya yang tidak dapat Anda beli lebih banyak?
Pertanyaan itu memiliki dua jawaban yang sangat berbeda di pasar saat ini. Qlik Sense mewakili pendekatan in-memory yang matang - memuat semuanya ke dalam RAM, simpan di sana, dan biarkan mesin asosiatif memberikan kecepatan melalui kedekatan. TURBOARD mewakili pendekatan hibrida – memperlakukan memori sebagai lapisan akselerasi untuk beban kerja yang paling diuntungkan, dan rute segala sesuatu yang lain untuk penyimpanan kolumnar atau sumber hidup yang dirancang untuk pekerjaan.
Kedua filosofi tersebut bekerja. Pertanyaan yang menarik adalah pendekatan mana yang lebih mampu bertahan saat kondisi berubah. Posting ini berjalan melalui apa yang sebenarnya terjadi pada setiap arsitektur saat data tumbuh, pengguna meningkat, dan RAM menjadi ketat – menggunakan dokumentasi Qlik sendiri dan arsitektur TURBOARD yang diterbitkan sebagai bukti.
Dua arsitektur, singkat
Qlik Sense dibangun di sekitar mesin asosiatif QIX. Ketika aplikasi dimuat, dataset yang belum diagregasi dipegang dalam RAM, bersama dengan struktur asosiatif yang menghubungkan setiap nilai ke setiap nilai lainnya. Pilihan pengguna dijawab dengan melintasi struktur dalam memori, dan hasil perhitungan disimpan dalam cache di RAM sehingga permintaan identik berikutnya kembali langsung.
Format QVD Qlik sendiri mempercepat lapisan pemuatan secara dramatis – laporan dokumentasi Qlik QVD membaca sepuluh hingga seratus kali lebih cepat daripada yang dibaca dari sumber lain – tetapi model runtime masih membutuhkan dataset kerja untuk hidup dalam memori fisik.
TURBOARD mengambil jalan yang berbeda. Data dapat diakses melalui koneksi langsung yang dioptimalkan menggunakan driver basis data asli, atau diimpor ke penyimpanan kolumnar berkinerja tinggi seperti MariaDB ColumnStore, ClickHouse, atau Vertica. Hasil kueri yang sering digunakan di cache di Redis, penyimpanan struktur data dalam memori.
Mekanisme cache-trigger memutuskan kapan hasil cache masih berlaku dan kapan sumber perlu ditanyai kembali. Memori digunakan dengan sengaja, untuk beban kerja di mana ia menghasilkan akselerasi paling banyak – bukan sebagai rumah default untuk semua data analitis.
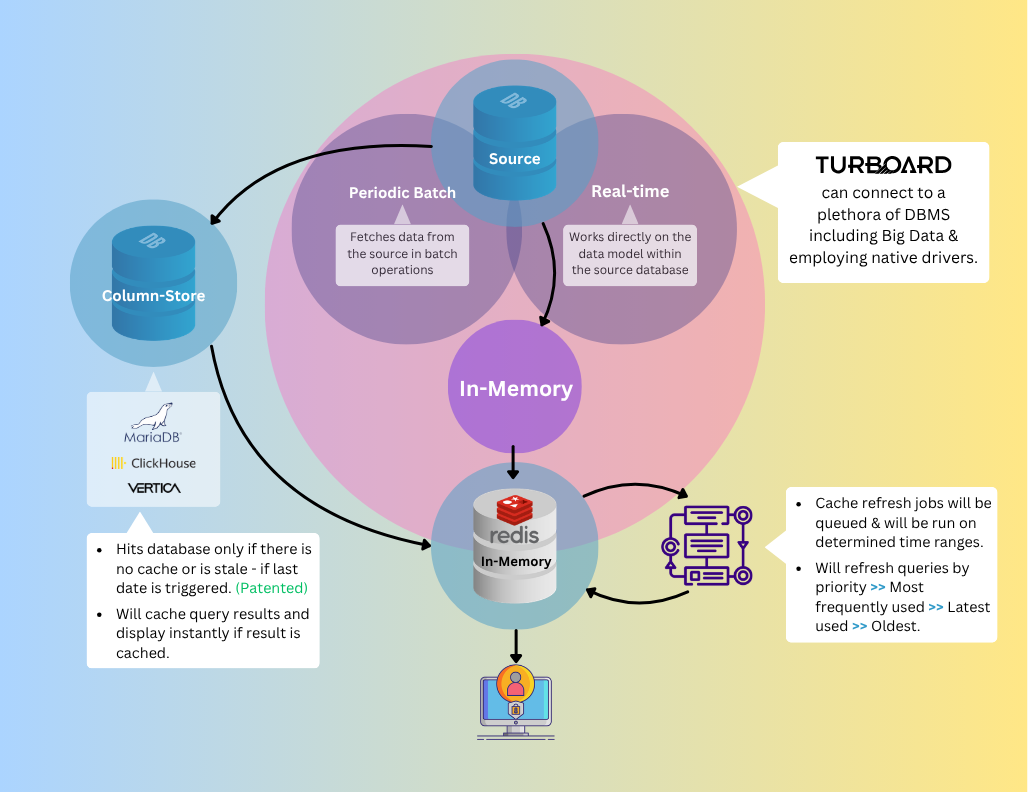
Diagram di atas menunjukkan bagaimana lapisan TURBOARD cocok bersama-sama. Sisa posting meneliti apa yang masing-masing arsitektur lakukan sebagai kondisi di sekitarnya semakin sulit.
Skenario yang adil: ketika dalam memori menang
Layak untuk mengatakan dengan jelas: Ketika dataset cocok dengan nyaman dalam RAM, ketika jumlah pengguna serentak tidak terlalu besar, dan ketika kapasitas lingkungan disesuaikan dengan aplikasi, Qlik Sense benar-benar cepat. Mesin asosiatif adalah bagian yang matang dari rekayasa, dan pengalaman pengguna mengklik melalui filter dan menonton agregasi menghitung ulang dalam milidetik adalah, dalam kondisi yang tepat, sangat baik. Untuk penyebaran departemen, aplikasi analitis yang terfokus, dan beban kerja di mana model data stabil dan dipahami dengan baik, pendekatan dalam memori adalah kekuatan nyata.
Ini adalah skenario yang sebagian besar demonstrasi produk dibangun di sekitar. Ini juga skenario yang memberi tahu Anda sedikit tentang bagaimana platform akan berperilaku setahun ke dalam produksi, setelah data telah berkembang, basis pengguna telah berkembang, dan tiga aplikasi lagi telah digunakan ke server yang sama.
Skenario penskalaan: di mana arsitektur menyimpang
Dokumentasi dukungan Qlik sendiri menjelaskan model memori secara rinci. Mesin beroperasi terhadap dua ambang batas yang dapat dikonfigurasi yang dikenal sebagai Set Kerja Rendah dan Bekerja Set Tinggi, dengan nilai default 70% dan 90% dari RAM fisik masing-masing. Di bawah ambang batas rendah, mesin mempertahankan hasil perhitungan cache secara agresif, pada prinsip bahwa memori yang tidak terpakai adalah memori yang terbuang. Setelah ambang batas rendah dilewati, mesin mulai mengusir hasil cache untuk membuat ruang untuk yang baru, memprioritaskan penggusuran berdasarkan usia, ukuran, dan waktu perhitungan asli. Setelah ambang batas tinggi dilewati, caching efektif berhenti, dan pagefile sistem operasi mungkin akan terlibat untuk menjaga mesin tetap hidup. Dokumentasi Qlik mencatat bahwa penggunaan pagefile dapat menurunkan kinerja secara signifikan.
Mekanisme dari apa yang terjadi di antara ambang batas itu lebih penting daripada ambang batas itu sendiri. Setiap hasil cache yang akan diusir adalah perhitungan yang perlu diulang pada saat pengguna memintanya. Saat penggusuran berakselerasi, beban komputasi bergeser dari memori ke CPU. Dalam lingkungan dengan banyak pengguna serentak, di mana banyak pengguna secara bersamaan memicu perhitungan yang tidak lagi memiliki jawaban cache, CPU menjadi bottleneck baru - dan tidak seperti tekanan memori, tekanan CPU bermanifestasi langsung sebagai latensi pengguna-terlihat: dasbor yang menggantung, filter yang membutuhkan detik untuk diterapkan, sesi yang time out.
Pendekatan hybrid TURBOARD mendistribusikan beban secara berbeda. Dataset yang belum diagregasi tidak perlu menempati RAM, karena penyimpanan kolumnar dirancang untuk menjawab pertanyaan analitis secara efisien dari disk hanya membaca kolom yang diperlukan kueri, mengeksploitasi kompresi berat, dan melayani agregasi pada kecepatan yang akan membutuhkan pemrosesan dalam memori satu dekade yang lalu. Pemuatan tambahan membuat penyimpanan kolumnar tetap mutakhir tanpa memaksa isi ulang penuh berulang, yang berarti pengguna mendapatkan data yang hampir real-time tanpa biaya memori untuk menahan dataset lengkap dalam RAM. Cache Redis kemudian mempercepat kueri yang paling diuntungkan dari percepatan - yang, dalam setiap penyebaran perusahaan nyata, adalah bagian kecil dari volume kueri total. Bagian selanjutnya menjelaskan mengapa.
Data langsung: Masalah Penemuan Langsung
Jawaban Qlik untuk beban kerja yang melebihi memori yang tersedia adalah Direct Discovery, sebuah mode di mana bidang dimensi dimuat ke dalam memori sementara bidang ukuran tetap dalam database sumber dan dipertanyakan sesuai permintaan. Maksud desainnya masuk akal; keterbatasan yang terdokumentasi sangat signifikan.
Keterbatasan yang terdokumentasi dari Direct Discovery (per bahan bantuan Qlik sendiri):
- Koneksi basis data bersama tunggal untuk semua pengguna aplikasi – dapat membanjiri database sumber di bawah konkurensi tinggi.
- Generated SQL tidak dioptimalkan; bergabung antara tabel dalam memori dan tabel Penemuan Langsung dapat menghasilkan klausa IN yang sangat besar yang menegangkan buffer kueri kueri database.
- Beberapa kemampuan analisis inti tidak didukung, termasuk Set Analysis, Insight Advisor, dan Dynamic Views.
- Tidak ada pengembangan lebih lanjut yang direncanakan untuk mengatasi keterbatasan ini, per pernyataan Qlik sendiri.
Untuk TURBOARD, konektivitas langsung bukanlah solusi untuk tekanan memori. Ini adalah bagian kelas satu dari arsitektur. Driver basis data asli – bukan koneksi ODBC generik – menyediakan akses langsung dan berkinerja tinggi ke sistem sumber, termasuk platform data besar seperti Apache Kudu. Mekanisme cache-trigger mencegah database sumber dikueri pada setiap klik pengguna: TURBOARD memantau kolom pemicu yang ditunjuk (seperti stempel waktu terakhir diperbarui) dan melayani hasil cache dari Redis ketika data yang mendasarinya tidak berubah, dan mengueri sumber hanya ketika pemicu menunjukkan data segar tersedia. Fitur analitis canggih tetap tersedia sepenuhnya apakah widget membaca dari cache, dari penyimpanan kolumnar, atau dari sumber langsung. Dasbor tunggal dapat mencampur ketiganya tanpa kompromi.
Wawasan Pareto, dan paten yang melindunginya
Dalam setiap penyebaran BI perusahaan, perilaku pengguna mengikuti pola yang dapat diprediksi. Sekitar 80% pengguna kembali berulang kali ke dasbor inti yang sama - ringkasan eksekutif, laporan kinerja bulanan, rollups regional. Sisa 20% adalah pengguna mahir yang menjalankan kueri ad-hoc yang mungkin tidak akan pernah dijalankan lagi dalam bentuk yang sama. Implikasi untuk manajemen memori langsung: tidak semua hasil cache sama-sama berharga, dan sistem yang memperlakukan mereka sebagai setara adalah membuang-buang sumber daya yang paling mahal.
Model pengusiran Qlik adalah perilaku-buta. Hasil cache dihapus berdasarkan usia, ukuran, dan waktu perhitungan asli - tidak berdasarkan seberapa sering pengguna aktual benar-benar memintanya. Ketika memori terisi, mesin tidak dapat membedakan dasbor seluruh tim eksekutif memeriksa setiap pagi dari permintaan satu kali yang kebetulan di-cache baru-baru ini.
TURBOARD mengambil pendekatan yang berlawanan. Setiap kali laporan dilihat, skor popularitasnya meningkat di Redis Sorted Set – struktur data yang dirancang untuk pola akses peringkat semacam ini. Sistem ini mempertahankan papan peringkat berkelanjutan yang laporan yang sebenarnya sedang digunakan, dan menggunakan leaderboard untuk memutuskan apa yang tetap dalam cache ketika memori yang ketat. Laporan yang paling banyak diminta dilindungi di Redis, di mana mereka kembali dengan nol latensi kepada mayoritas pengguna yang bergantung pada mereka. Kueri pengguna mahir yang melewatkan cache dialihkan ke penyimpanan kolumnar atau sumber langsung – yang keduanya direkayasa untuk menjawab pertanyaan tersebut dengan cepat tanpa menggusur konten cache bernilai tinggi.
Artificial Intelligence-Powered Rapid Search Result Display System dengan Adaptasi terhadap Kebiasaan Pengguna
Mekanisme ini adalah subjek dari paten yang diberikan. Sistem ini diajukan oleh E-Kalite (perusahaan induk TURBOARD) pada tahun 2022 dan diberikan pada tahun 2025. Paten ini mencakup metode percepatan tampilan data pada antarmuka pengguna, memperpendek waktu pemuatan input / output, dan mengurangi frekuensi akses ke penyimpanan data dan perangkat keras yang mentransmitasi data - dengan kata lain, kombinasi penilaian berbasis penggunaan, penyegaran cache cerdas, dan deteksi data kedaluwarsa berbasis pemicu yang memungkinkan TURBOARD menyajikan beban kerja perusahaan pada anggaran memori yang murni akan mendorong arsitektur dalam memori murni ke penggunaan pagefile.
Intinya jelas: ketika memori berlimpah, caching yang mengabaikan perilaku pengguna mengurangi efisiensi. Ketika memori langka, kinerja yang berkurang.
Berdampingan
| Pertanyaan | Pendekatan Qlik Sense | Pendekatan TURBOARD |
|---|---|---|
| Di mana data hidup pada saat runtime? | Dalam RAM, secara penuh | Di penyimpanan kolumnar atau sumber langsung; hasil cache selektif di Redis |
| Apa yang terjadi ketika memori terisi? | Cache penggusuran berdasarkan usia/ukuran, kemudian pagefile | Dipertahankan menurut skor penggunaan; permintaan lainnya dilayani penyimpanan kolumnar atau sumber langsung |
| Bagaimana penggunaan berulang ditangani? | Cache hasil dalam memori, dihapus tanpa mempertimbangkan penggunaan | Redis cache, dipertahankan oleh skor penggunaan (dipatenkan) |
| Bagaimana data dijaga tetap mutakhir? | Full atau QVD-incremental reloads ke RAM | Pemuatan kolumnar inkremental + pemicu cache |
| Bagaimana pertanyaan langsung ditangani? | Penemuan langsung, dengan batas terdokumentasi | Driver native, seluruh kemampuan analitik dipertahankan |
| Filosofi Scaling | Penyediaan lebih banyak memori | Gunakan memori selektif, rute sisanya |
Kesimpulan
Qlik Sense tetap menjadi platform analitik dalam memori yang mampu, dan dalam kondisi yang dirancang untuk – dataset terbatas, konkurensi yang dapat diprediksi, penyediaan memori yang murah hati – itu berkinerja baik. Pertanyaan yang coba dijawab oleh posting ini adalah apa yang terjadi karena kondisi tersebut menjadi lebih sulit untuk dipenuhi. Volume data tidak menyusut. Tuntutan jumlah pengguna serentak tidak menurun. Dan biaya dan ketersediaan memori, untuk pertama kalinya dalam waktu yang lama, bergerak ke arah yang salah.
Arsitektur TURBOARD bertumpu pada keyakinan bahwa kinerja BI dekade berikutnya akan dimenangkan platform yang menggunakan memori secara cerdas, bukan secara berlebihan. Akses data hibrida, penyimpanan kolumnar, koneksi langsung native, dan cache berpaten dengan skor penggunaan memungkinkan TURBOARD memberikan kinerja skala perusahaan dengan anggaran memori yang sulit dipenuhi arsitektur in-memory murni.
Untuk organisasi yang menghadapi tabrakan data yang berkembang, bertambahnya pengguna serentak, dan pengetatan ekonomi perangkat keras, perbedaan dalam pendekatan itu tidak lagi bersifat akademis. Ini adalah perbedaan antara platform yang menskalakan dengan bisnis dan platform yang menskalakan dengan anggaran pengadaan.
Siap untuk melihat perbedaan?
Jika Anda mengevaluasi Qlik Sense – atau sudah menjalankannya dan mulai merasakan tekanan memori yang dijelaskan dalam posting ini – kami ingin menunjukkan kepada Anda bagaimana arsitektur hibrida TURBOARD menangani beban kerja yang sama.
Pesan walkthrough dengan tim kami dan lihat platform beraksi dengan data Anda sendiri. Tidak ada tekanan – kami lebih suka Anda menemukan kecocokan yang tepat untuk kebutuhan spesifik Anda.
Anda juga dapat membuka halaman Perbandingan BI Lengkap untuk melihat posisi kami dalam lebih banyak skenario perusahaan.
Blog



Bawa satu pertanyaan bisnis yang nyata. Lihat bagaimana TURBOARD menjawabnya.
Kami mendemonstrasikan JAS pada laporan Anda, definisi Anda, dan konteks keamanan Anda — bukan pada basis data contoh yang generik.