जब BI मेमोरी की सीमा से टकराता है: कम RAM के दौर में प्रदर्शन पर पुनर्विचार
Qlik Sense के इन-मेमोरी मॉडल का क्या होता है जब रैम अब सस्ता या अंतहीन उपलब्ध नहीं है? हम इसकी तुलना Qlik के अपने दस्तावेज़ और बुद्धिमान कैशिंग पर हमारे दिए गए पेटेंट का उपयोग करके TURBOARD के हाइब्रिड आर्किटेक्चर से करते हैं।
पिछले एक दशक के अधिकांश समय के लिए, व्यावसायिक खुफिया प्लेटफार्मों को एक आरामदायक धारणा पर बनाया गया था: स्मृति सस्ती, सघन और समस्याएँ हल करने के लिए बढ़ाना आसान होती रहेगी। वह धारणा चुपचाप टूट रही है। एआई इंफ्रास्ट्रक्चर बिल्डआउट वैश्विक डीआरएएम और एचबीएम आपूर्ति के अभूतपूर्व हिस्से को अवशोषित कर रहे हैं, और प्रमुख मेमोरी निर्माताओं ने चेतावनी दी है कि 2026 के माध्यम से बाधाओं के गहरा होने की संभावना है। एंटरप्राइज़ बीआई टीमों के लिए, व्यावहारिक प्रभाव सरल है - आपका एनालिटिक्स प्लेटफॉर्म जिस पर निर्भर करता है वह अधिक महंगा, अधिक विवादित और मांग पर स्केल करने के लिए कठिन होता जा रहा है।
यह उस प्रश्न को बदल देता है जो मायने रखता है।
पारंपरिक बीआई प्रदर्शन का प्रश्न था: डेटासेट मेमोरी में समा जाए तो डैशबोर्ड कितना तेज़ है? विक्रेताओं को यह प्रश्न पसंद है, क्योंकि उत्तर लगभग हमेशा “बहुत तेज़” होता है। लेकिन वास्तविक संचालन में प्लेटफ़ॉर्म टिक पाएगा या नहीं, यह अब उस प्रश्न से तय नहीं होता। असली प्रश्न है: डेटा और समवर्ती उपयोगकर्ता बढ़ें, और मेमोरी आसानी से बढ़ाई न जा सके, तो प्लेटफ़ॉर्म कैसे व्यवहार करता है?
आज बाज़ार में इस प्रश्न के दो अलग उत्तर हैं। Qlik Sense परिपक्व इन-मेमोरी दृष्टिकोण अपनाता है: सब कुछ रैम में लोड करके वहीं रखें और साहचर्य इंजन को निकट उपलब्ध डेटा से गति देने दें। TURBOARD हाइब्रिड दृष्टिकोण अपनाता है: मेमोरी को उन कार्यभारों के लिए त्वरण परत बनाएँ जिन्हें सबसे अधिक लाभ होता है, और बाकी कार्य उपयुक्त कॉलमर स्टोरेज या लाइव स्रोतों को भेजें।
दोनों दृष्टिकोण काम करते हैं। प्रश्न यह है कि परिस्थितियाँ बदलने पर कौन अधिक टिकाऊ रहता है। यह लेख डेटा और उपयोगकर्ता बढ़ने तथा रैम सीमित होने पर दोनों आर्किटेक्चर के व्यवहार को Qlik के अपने दस्तावेज़ों और TURBOARD के प्रकाशित आर्किटेक्चर के आधार पर समझाता है।
दो आर्किटेक्चर, संक्षेप में
Qlik Sense QIX साहचर्य इंजन के आसपास बनाया गया है। जब कोई एप्लिकेशन लोड होता है, तो बिना समेकित किया गया डेटासेट रैम में आयोजित किया जाता है, साथ ही साहचर्य संरचनाएँ जो हर मूल्य को हर दूसरे मूल्य से जोड़ती हैं। उपयोगकर्ता चयनों का उत्तर उन इन-मेमोरी संरचनाओं को पार करके दिया जाता है, और गणना के परिणाम रैम में कैश किए जाते हैं, इसलिए बाद के समान अनुरोध तुरंत वापस आ जाते हैं।
Qlik का अपना QVD प्रारूप लोडिंग लेयर को नाटकीय रूप से तेज करता है - Qlik प्रलेखन रिपोर्ट QVD अन्य स्रोतों से पढ़ने की तुलना में दस से एक सौ गुना तेज पढ़ता है - लेकिन रनटाइम मॉडल को अभी भी भौतिक स्मृति में रहने के लिए काम करने वाले डेटासेट की आवश्यकता होती है।
TURBOARD एक अलग रास्ता अपनाता है। डेटा को देशी डेटाबेस ड्राइवरों का उपयोग करके अनुकूलित लाइव कनेक्शन के माध्यम से एक्सेस किया जा सकता है, या MariaDB कॉलमस्टोर, ClickHouse या वर्टिका जैसे उच्च-प्रदर्शन वाले कॉलमर स्टोर में आयात किया जा सकता है। अक्सर उपयोग किए जाने वाले क्वेरी परिणाम Redis में कैश किए जाते हैं, इन-मेमोरी डेटा संरचना स्टोर।
एक कैश-ट्रिगर तंत्र तय करता है कि कैश किए गए परिणाम अभी भी कब मान्य हैं और स्रोत को फिर से पूछताछ करने की आवश्यकता कब है। मेमोरी का उपयोग जानबूझकर किया जाता है, वर्कलोड के लिए जहां यह सबसे अधिक त्वरण पैदा करता है - सभी विश्लेषणात्मक डेटा के लिए डिफ़ॉल्ट घर के रूप में नहीं।
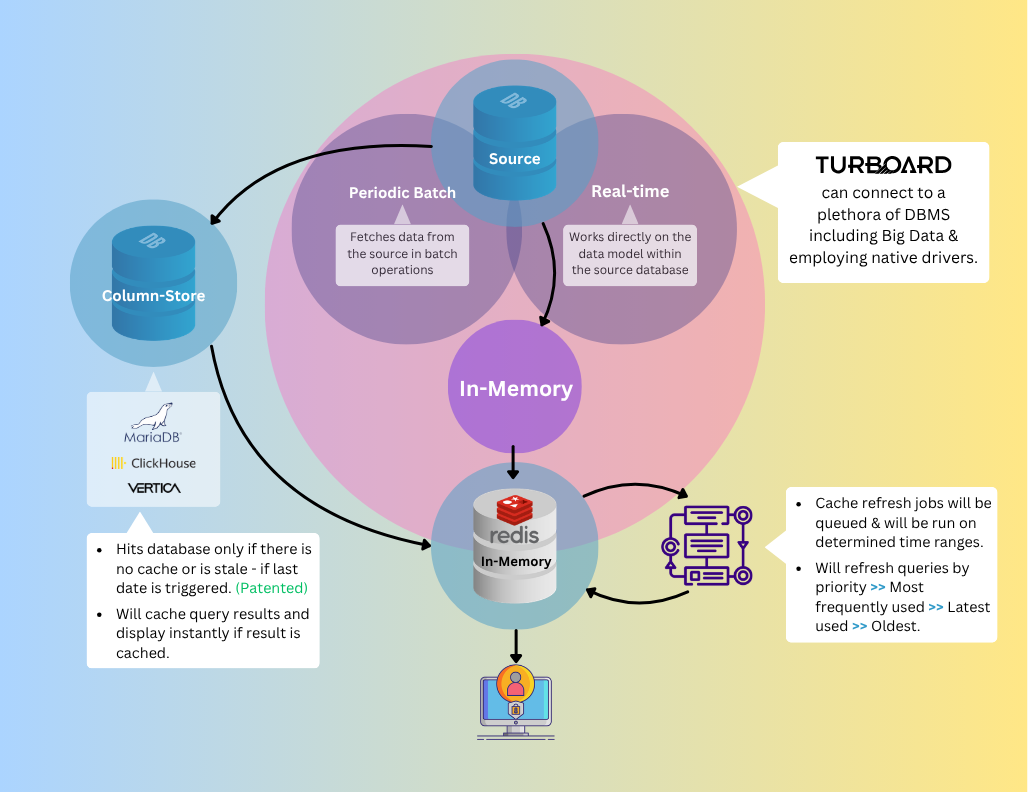
ऊपर दिए गए आरेख से पता चलता है कि TURBOARD की परतें एक साथ कैसे फिट होती हैं। बाकी पोस्ट जांच करता है कि प्रत्येक वास्तुकला क्या करती है क्योंकि इसके आसपास की स्थितियां कठिन हो जाती हैं।
निष्पक्ष परिदृश्य: जब स्मृति में जीतता है
यह स्पष्ट रूप से कहने लायक है: जब डेटासेट रैम में आराम से फिट बैठता है, जब एक साथ उपयोगकर्ताओं की संख्या सीमित होती है, और जब परिवेश के संसाधन एप्लिकेशन के अनुरूप होते हैं, तो Qlik Sense वास्तव में तेज होता है। एसोसिएटिव इंजन इंजीनियरिंग का एक परिपक्व टुकड़ा है, और फ़िल्टर चुनने और समेकित परिणामों को मिलीसेकंड में दोबारा गणना होते देखने का उपयोगकर्ता अनुभव, उचित परिस्थितियों में उत्कृष्ट है। विभागीय तैनाती, केंद्रित विश्लेषणात्मक अनुप्रयोगों और कार्यभार के लिए जहां डेटा मॉडल स्थिर और अच्छी तरह से समझा जाता है, इन-मेमोरी दृष्टिकोण एक वास्तविक ताकत है।
यह वह परिदृश्य है जो अधिकांश उत्पाद प्रदर्शन चारों ओर बनाए जाते हैं। यह वह परिदृश्य भी है जो आपको कम से कम बताता है कि डेटा बढ़ने के बाद, डेटा बढ़ने के बाद एक मंच उत्पादन में एक वर्ष कैसे व्यवहार करेगा, उपयोगकर्ता आधार का विस्तार हुआ है, और एक ही सर्वर पर तीन और अनुप्रयोगों को तैनात किया गया है।
स्केलिंग परिदृश्य: जहां आर्किटेक्चर अलग हो जाते हैं
Qlik का अपना समर्थन प्रलेखन मेमोरी मॉडल का विस्तार से वर्णन करता है। इंजन दो विन्यास योग्य थ्रेसहोल्ड के खिलाफ संचालित होता है जिसे कहा जाता है काम करना सेट कम और कार्य सेट उच्च, 70% और 90% भौतिक रैम के डिफ़ॉल्ट मूल्यों के साथ क्रमशः। कम दहलीज के नीचे, इंजन कैश्ड गणना के परिणामों को आक्रामक रूप से बरकरार रखता है, इस सिद्धांत पर कि बिना इस्तेमाल की मेमोरी व्यर्थ जाती है। एक बार कम दहलीज पार हो जाने के बाद, इंजन नए परिणामों के लिए जगह बनाने के लिए कैश्ड परिणामों को बेदखल करना शुरू कर देता है, उम्र, आकार और मूल गणना समय द्वारा बेदखली को प्राथमिकता देता है। एक बार उच्च सीमा पार हो जाने के बाद, कैशिंग प्रभावी रूप से बंद हो जाता है, और इंजन को जीवित रखने के लिए ऑपरेटिंग सिस्टम के पेजफाइल को लगाया जा सकता है। Qlik के दस्तावेज़ीकरण नोट करते हैं कि पेजफ़ाइल का उपयोग प्रदर्शन को काफी नीचा दिखा सकता है।
उन दहलीजों के बीच क्या होता है, इसके यांत्रिकी स्वयं दहलीज से अधिक मायने रखती हैं। प्रत्येक कैश किया गया परिणाम जो बेदखल हो जाता है वह एक गणना है जिसे अगली बार जब कोई उपयोगकर्ता अनुरोध करता है तो उसे फिर से गणना करने की आवश्यकता होगी। जैसे-जैसे बेदखली तेज होती है, कम्प्यूटेशनल लोड मेमोरी से सीपीयू में शिफ्ट हो जाता है। एक अधिक समवर्ती उपयोगकर्ताओं वाले परिवेश में, जहां कई उपयोगकर्ता एक साथ उन गणनाओं को ट्रिगर कर रहे हैं जिनके पास अब कैश्ड उत्तर नहीं हैं, सीपीयू नई अड़चन बन जाता है - और मेमोरी दबाव के विपरीत, सीपीयू दबाव सीधे उपयोगकर्ता-दृश्यमान विलंबता के रूप में प्रकट होता है: डैशबोर्ड जो लटकते हैं, फ़िल्टर जो लागू करने में सेकंड लेते हैं, समय सीमा पार करने वाले सत्र।
TURBOARD का हाइब्रिड दृष्टिकोण लोड को अलग तरह से वितरित करता है। बिना समेकित किए गए डेटासेट को रैम में रखने की आवश्यकता नहीं है, क्योंकि स्तंभ स्टोर को डिस्क से कुशलतापूर्वक विश्लेषणात्मक प्रश्नों का उत्तर देने के लिए डिज़ाइन किया गया है - केवल वे कॉलम पढ़ता है जिनकी क्वेरी को ज़रूरत है, उच्च संपीड़न का उपयोग करती है, और गति पर एकत्रीकरण की सेवा करती है जिसके लिए एक दशक पहले स्मृति प्रसंस्करण की आवश्यकता होती थी। वृद्धिशील लोडिंग बार-बार पूर्ण पुनः लोड को मजबूर किए बिना कॉलमर स्टोर को ताजा रखती है, जिसका अर्थ है कि उपयोगकर्ता रैम में पूर्ण डेटासेट रखने की स्मृति लागत के बिना निकट-लाइव डेटा का अनुभव करते हैं। Redis कैश तब उन प्रश्नों को तेज करता है जो त्वरण से सबसे अधिक लाभान्वित होते हैं - जो किसी भी वास्तविक उद्यम परिनियोजन में, कुल क्वेरी वॉल्यूम का एक छोटा सबसेट है। अगला खंड बताता है कि क्यों।
लाइव डेटा: प्रत्यक्ष डिस्कवरी समस्या
उपलब्ध मेमोरी से अधिक होने वाले कार्यभार के लिए Qlik का उत्तर प्रत्यक्ष डिस्कवरी है, एक मोड जिसमें आयाम फ़ील्ड मेमोरी में लोड किए जाते हैं जबकि माप फ़ील्ड स्रोत डेटाबेस में रहते हैं और ज़रूरत पड़ने पर क्वेरी किए जाते हैं। डिजाइन का इरादा उचित है; प्रलेखित सीमाएं महत्वपूर्ण हैं।
प्रत्यक्ष डिस्कवरी की प्रलेखित सीमाएं (प्रति क्लिक की अपनी सहायता सामग्री):
- एकल साझा डेटाबेस कनेक्शन एक आवेदन के सभी उपयोगकर्ताओं के लिए — उच्च सहमति के तहत स्रोत डेटाबेस बाढ़ कर सकते हैं.
- उत्पन्न एसक्यूएल अनुकूलित नहीं है; इन-मेमोरी टेबल और डायरेक्ट डिस्कवरी टेबल्स के बीच शामिल होते हैं जो बहुत बड़े IN खंडों का उत्पादन कर सकते हैं जो डेटाबेस क्वेरी बफर को तनाव देते हैं।
- कई मुख्य विश्लेषणात्मक क्षमताएं असमर्थित हैं, सेट विश्लेषण, अंतर्दृष्टि सलाहकार और गतिशील दृश्य शामिल हैं।
- आगे कोई विकास की योजना नहीं है इन सीमाओं को संबोधित करने के लिए, Qlik के अपने बयान के अनुसार।
टर्बोडिंग के लिए, लाइव कनेक्टिविटी मेमोरी प्रेशर के लिए एक समाधान नहीं है। यह वास्तुकला का प्रथम श्रेणी का हिस्सा है। मूल डेटाबेस ड्राइवर - सामान्य ODBC कनेक्शन के बजाय - अपाचे कुडू जैसे बड़े डेटा प्लेटफॉर्म सहित स्रोत सिस्टम के लिए प्रत्यक्ष, उच्च-प्रदर्शन पहुंच प्रदान करते हैं। कैश-ट्रिगर तंत्र स्रोत डेटाबेस को हर उपयोगकर्ता क्लिक पर हिट होने से रोकता है: TURBOARD एक निर्दिष्ट ट्रिगर फ़ील्ड (जैसे कि अंतिम-अपडेटेड टाइमस्टैम्प) देखता है और Redis से कैश किए गए परिणाम प्रदान करता है जब अंतर्निहित डेटा नहीं बदला है, स्रोत को केवल तभी क्वेरी करता है जब ट्रिगर ताजा डेटा उपलब्ध होता है। उन्नत विश्लेषणात्मक विशेषताएं पूरी तरह से उपलब्ध रहती हैं कि क्या कोई विजेट कैश से, कॉलमर स्टोर से या लाइव स्रोत से पढ़ रहा है। एक एकल डैशबोर्ड बिना किसी समझौते के तीनों को मिला सकता है।
पेरेटो अंतर्दृष्टि, और पेटेंट जो इसकी रक्षा करता है
किसी भी उद्यम बीआई परिनियोजन में, उपयोगकर्ता व्यवहार एक अनुमानित पैटर्न का पालन करता है। मोटे तौर पर 80% उपयोगकर्ता एक ही कोर डैशबोर्ड पर बार-बार लौटते हैं - कार्यकारी सारांश, मासिक प्रदर्शन रिपोर्ट, क्षेत्रीय रोलअप। शेष 20% पावर उपयोगकर्ता हैं जो तदर्थ प्रश्न चला रहे हैं जिन्हें फिर से एक ही रूप में कभी नहीं चलाया जा सकता है। स्मृति प्रबंधन के लिए निहितार्थ प्रत्यक्ष है: सभी कैश किए गए परिणाम समान रूप से मूल्यवान नहीं हैं, और एक प्रणाली जो उन्हें समकक्ष के रूप में व्यवहार करती है, वह अपने सबसे महंगे संसाधन को बर्बाद कर रही है।
Qlik का निष्कासन मॉडल व्यवहार-अंधे है। कैश्ड परिणाम उम्र, आकार और मूल गणना समय के आधार पर हटा दिए जाते हैं - इस बात पर आधारित नहीं है कि वास्तविक उपयोगकर्ता वास्तव में कितनी बार उनका अनुरोध करते हैं। जब मेमोरी भरती है, तो इंजन डैशबोर्ड को अलग नहीं कर सकता है, पूरी कार्यकारी टीम हर सुबह एक बार की क्वेरी से जांच करती है जो हाल ही में कैश की गई थी।
TURBOARD विपरीत दृष्टिकोण लेता है। हर बार जब एक रिपोर्ट देखी जाती है, तो इसका लोकप्रियता स्कोर एक Redis सॉर्टेड सेट में बढ़ जाता है - एक डेटा संरचना जिसे वास्तव में इस तरह के रैंक-एक्सेस पैटर्न के लिए डिज़ाइन किया गया है। सिस्टम एक निरंतर लीडरबोर्ड बनाए रखता है जिसमें से रिपोर्ट का वास्तव में उपयोग किया जा रहा है, और उस लीडरबोर्ड का उपयोग यह तय करने के लिए करता है कि मेमोरी तंग होने पर कैश में क्या रहता है। सबसे अधिक अनुरोध की गई रिपोर्ट Redis में संरक्षित हैं, जहां वे उन पर निर्भर अधिकांश उपयोगकर्ताओं को शून्य विलंबता के साथ लौटते हैं। वे उन्नत उपयोगकर्ता क्वेरी जिनके परिणाम कैश में नहीं मिलते कॉलमर स्टोर या लाइव स्रोत पर रूट किए जाते हैं - जो दोनों उच्च-मूल्य वाली कैश्ड सामग्री को विस्थापित किए बिना उन प्रश्नों का तुरंत उत्तर देने के लिए इंजीनियर हैं।
उपयोगकर्ता की आदतों के अनुकूलन के साथ कृत्रिम बुद्धिमत्ता-संचालित रैपिड सर्च रिजल्ट डिस्प्ले सिस्टम
यह तंत्र एक दिए गए पेटेंट का विषय है। यह प्रणाली 2022 में ई-कलाइट (TURBOARD की मूल कंपनी) द्वारा दायर की गई थी और 2025 में दी गई थी। पेटेंट में उपयोगकर्ता इंटरफ़ेस पर डेटा डिस्प्ले को तेज करने, इनपुट/आउटपुट लोडिंग समय को छोटा करने और डेटा-स्टोरिंग और डेटा-संचारित हार्डवेयर तक पहुंच की आवृत्ति को कम करने की विधि शामिल है - दूसरे शब्दों में, उपयोग-आधारित स्कोरिंग, बुद्धिमान कैश रिफ्रेश और ट्रिगर के आधार पर पुराने डेटा की पहचान करने का संयोजन जो TURBOARD को मेमोरी बजट पर एंटरप्राइज वर्कलोड की सेवा करने देता है जो विशुद्ध रूप से मेमोरी आर्किटेक्चर को पेजफाइल क्षेत्र में धकेल देगा।
रणनीतिक बात स्पष्ट है: जब मेमोरी प्रचुर हो, तो उपयोगकर्ता व्यवहार की अनदेखी करने वाली कैशिंग से कार्यकुशलता घटती है। मेमोरी कम होने पर प्रदर्शन घटता है।
साइड-दर-साइड
| प्रश्न | Qlik सेंस दृष्टिकोण | TURBOARD दृष्टिकोण |
|---|---|---|
| रनटाइम पर डेटा कहां रहता है? | रैम में, पूर्ण में | स्तंभ स्टोर या लाइव स्रोत में; परिणाम Redis में चुनिंदा रूप से कैश किए गए हैं |
| क्या होता है जब स्मृति भरती है? | उम्र/आकार के द्वारा कैश बेदखली, फिर पेजफाइल | उपयोग के स्कोर के आधार पर प्रतिधारण; बाकी अनुरोध कॉलमर स्टोर या लाइव स्रोत से पूरे होते हैं |
| बार-बार उपयोग कैसे नियंत्रित किया जाता है? | इन-मेमोरी परिणाम कैश, आँख बंद करके बेदखल कर दिया गया | Redis कैश, उपयोग स्कोर द्वारा बनाए रखा (पेटेंट) |
| डेटा को ताज़ा कैसे रखा जाता है? | रैम में पूर्ण या QVD-वृद्धिशील पुनः लोड | वृद्धिशील स्तंभ लोड + कैश ट्रिगर |
| लाइव प्रश्नों को कैसे संभाला जाता है? | प्रत्यक्ष डिस्कवरी, प्रलेखित सीमाओं के साथ | देशी ड्राइवरों, पूर्ण विश्लेषण को बरकरार रखा गया |
| स्केलिंग दर्शन | अधिक मेमोरी उपलब्ध कराएँ | स्मृति का चयनात्मक रूप से उपयोग करें, बाकी को रूट करें |
निष्कर्ष
Qlik Sense एक सक्षम इन-मेमोरी एनालिटिक्स प्लेटफॉर्म बना हुआ है, और जिन परिस्थितियों में इसे - बाध्य डेटासेट, अनुमानित समवर्ती, उदार स्मृति प्रावधान के लिए डिज़ाइन किया गया था - यह अच्छा प्रदर्शन करता है। इस पोस्ट ने जिस प्रश्न का उत्तर देने की कोशिश की है, वह यह है कि क्या होता है क्योंकि उन स्थितियों को पूरा करना कठिन हो जाता है। डेटा वॉल्यूम सिकुड़ नहीं रहे हैं। एक साथ उपयोगकर्ताओं की संख्या संबंधी अपेक्षाएँ कम नहीं हो रही हैं। और स्मृति की लागत और उपलब्धता, लंबे समय में पहली बार, गलत दिशा में आगे बढ़ रही है।
TURBOARD का आर्किटेक्चर इस धारणा पर आधारित है कि अगले दशक में बीआई प्रदर्शन में वे प्लेटफ़ॉर्म आगे रहेंगे जो मेमोरी का भरपूर इस्तेमाल करने के बजाय समझदारी से उपयोग करेंगे। हाइब्रिड डेटा एक्सेस, कॉलमर स्टोरेज, नेटिव लाइव कनेक्टिविटी और उपयोग-स्कोर वाला पेटेंट कैश, TURBOARD को ऐसे मेमोरी बजट में एंटरप्राइज़ स्तर का प्रदर्शन देने में मदद करते हैं जिनमें पूरी तरह इन-मेमोरी आर्किटेक्चर को कठिनाई होती है।
बढ़ते डेटा, बढ़ते समवर्ती उपयोग और हार्डवेयर की बढ़ती लागत और सीमित उपलब्धता का सामना कर रहे संगठनों के लिए, दृष्टिकोण में अंतर अब अकादमिक नहीं है। यह एक मंच के बीच का अंतर है जो व्यवसाय के साथ स्केल करता है और एक मंच जो खरीद बजट के साथ बढ़ता है।
अंतर देखने के लिए तैयार हैं?
यदि आप Qlik Sense का मूल्यांकन कर रहे हैं - या पहले से ही इसे चला रहे हैं और इस पोस्ट में वर्णित स्मृति दबाव को महसूस करना शुरू कर रहे हैं - तो हम आपको यह दिखाना पसंद करेंगे कि TURBOARD की हाइब्रिड वास्तुकला समान कार्यभार को कैसे संभालती है।
हमारी टीम के साथ एक प्रदर्शन सत्र बुक करें और अपने डेटा के साथ प्लेटफ़ॉर्म को काम करते देखें। कोई दबाव नहीं है — हम चाहते हैं कि आप अपनी आवश्यकताओं के लिए सही विकल्प चुनें।
अन्य एंटरप्राइज़ परिदृश्यों में हमारी स्थिति देखने के लिए आप पूर्ण बीआई तुलना पेज भी देख सकते हैं।
ब्लॉग



एक असली बिज़नेस सवाल लाइए। देखिए TURBOARD उसका जवाब कैसे देता है।
हम JAS को किसी सामान्य नमूना डेटाबेस पर नहीं, बल्कि आपकी रिपोर्टों, आपकी परिभाषाओं और आपके सुरक्षा संदर्भ पर प्रदर्शित करते हैं।